


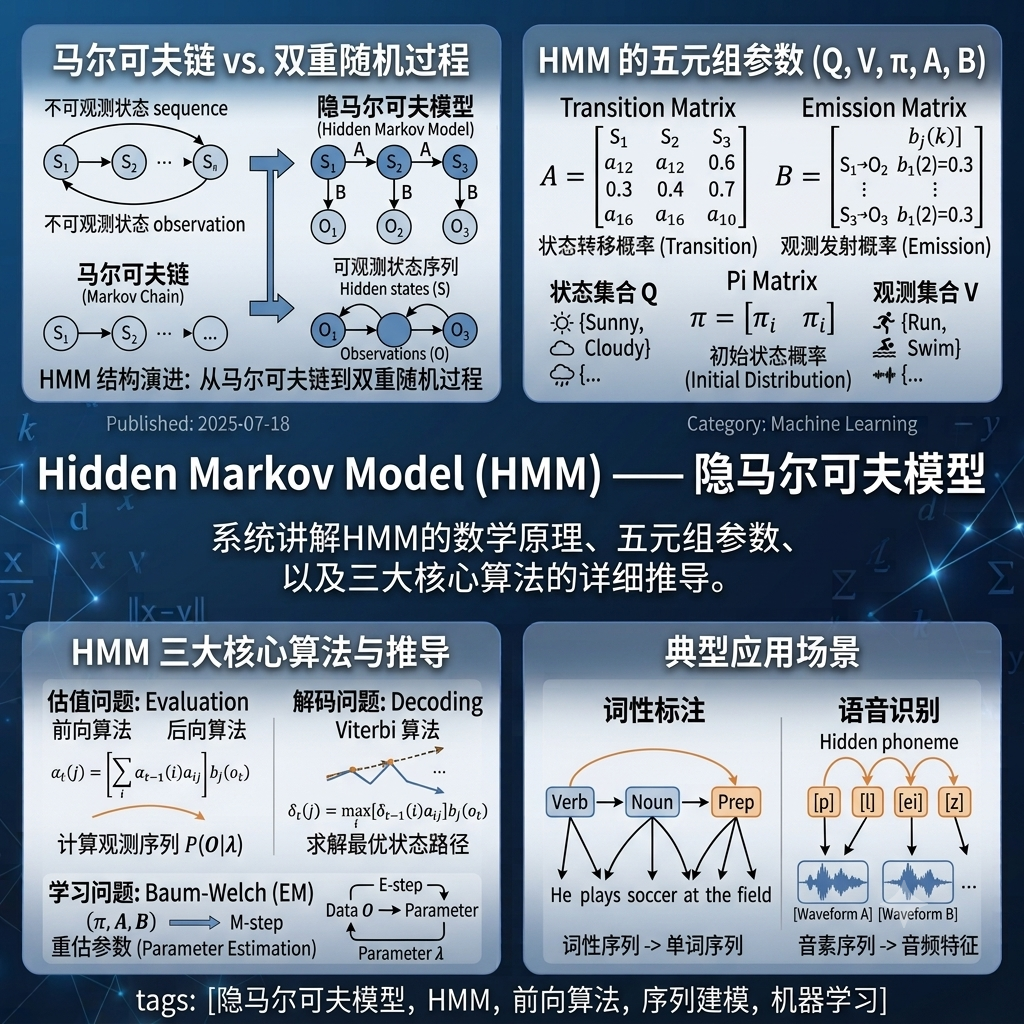
Hidden Markov Model (HMM) —— 隐马尔可夫模型
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
上一篇文章中,我们完整推导了 GBM(梯度提升机) 的通用框架——它以“拟合负梯度”为核心,将 AdaBoost 的指数损失泛化为任意可微损失,在函数空间中实现了梯度下降。这个框架在理论上极其优雅,但在工程实践中却面临着两个严峻的挑战:训练速度慢(每次分裂需要扫描全部数据)和内存消耗大(需存储预排序信息),使其在大规模数据集上的应用受到限制。
XGBoost(Extreme Gradient Boosting) 由陈天奇于 2014 年提出,是首个将 GBM 的通用框架推进为工业级实现的开山之作。其核心突破在于两点:其一,引入二阶泰勒展开,利用损失函数的二阶梯度(Hessian)指导分裂方向 —— 相当于在函数空间中做牛顿法而非梯度下降,收敛更快;其二,在目标函数中显式加入正则化项(叶子节点数量惩罚与叶子权重 L2 惩罚),精确控制模型复杂度,从源头抑制过拟合。
LightGBM 由微软团队于 2017 年推出,在 XGBoost 的基础上进一步聚焦于大规模数据场景下的训练效率。它通过直方图算法将连续特征离散化为有限个桶,将分裂查找的复杂度从 降至 ;通过 GOSS(基于梯度的单边采样) 保留大梯度“难样本”并加权采样小梯度样本,在保证精度的同时大幅缩减训练数据量;通过 EFB(互斥特征捆绑)将稀疏的互斥特征合并,降低特征维度。生长策略上,XGBoost 采用 Level-wise(按层平衡生长),LightGBM 采用 Leaf-wise(每次选增益最大的叶子分裂),后者收敛更快但需更精细的防过拟合参数控制。
Note读完本文,你将掌握从“通用框架”到“工业级实现”的完整技术演进路径。XGBoost 与 LightGBM 是目前树模型集成学习的工程巅峰,也是实际项目中最常选用的两类算法。
至此,我们完成了第二阶段:树模型与集成学习的全部内容——从单棵决策树的生长与剪枝,到 Bagging 与随机森林的并行降方差,再到 AdaBoost、GBM、XGBoost、LightGBM 的串行降偏差迭代。
下一阶段,我们将从监督学习转向无监督学习,以 PCA(主成分分析) 为起点,探索数据降维与结构发现的底层逻辑。
在经典的GBM中,每一轮迭代通过拟合损失函数的一阶梯度(负梯度) 来更新模型。这本质上是在函数空间中做梯度下降 —— 只利用了目标函数的一阶导数信息。
XGBoost的核心创新在于:将损失函数做二阶泰勒展开,使用一阶导数和二阶导数共同决定下一步的方向。这相当于在函数空间中做牛顿法(Newton’s Method) 而非梯度下降法。
数学推导:
假设前 轮已经得到模型 ,第 轮要学习的新树为 ,则新的预测值为:
XGBoost的目标函数为:
其中 是正则化项。
对损失函数 在 处做二阶泰勒展开:
其中:
是一阶梯度(与GBM相同),而 是二阶梯度(Hessian) ——这是XGBoost新增的信息。
去掉常数项后,目标函数简化为:
二阶梯度的价值一阶梯度只告诉模型“往哪个方向走”,而二阶梯度还告诉模型“每一步应该走多远”。因此,XGBoost的收敛速度比传统GBM更快。
XGBoost的另一个关键创新是在目标函数中显式加入了正则化项。
对于第 棵树 ,其复杂度定义为:
其中:
两项正则化的作用
正则项 作用 效果 惩罚叶子节点数量 鼓励树结构更简单,减少分裂 L2正则化惩罚叶子权重 防止单个叶子权重过大,平滑预测
将正则化项代入目标函数,并按照叶子节点进行归组:
其中 ,。
对于固定的树结构 ,每个叶子节点的最优权重为:
代入后得到结构分数(Structure Score) :
这个分数衡量了一棵树的质量——值越小,树的结构越好。
代码实现:
import numpy as np
def xgboost_gain(G_L, H_L, G_R, H_R, G, H, lambda_=1.0, gamma=0.0): """ 计算XGBoost中某个分裂的增益 G_L, H_L: 左子节点的一阶和二阶梯度之和 G_R, H_R: 右子节点的一阶和二阶梯度之和 G, H: 父节点的一阶和二阶梯度之和 """ # 分裂前的损失 loss_before = -0.5 * (G**2 / (H + lambda_)) + gamma
# 分裂后的损失 loss_after = -0.5 * (G_L**2 / (H_L + lambda_) + G_R**2 / (H_R + lambda_)) + 2 * gamma
# 增益 = 分裂前损失 - 分裂后损失 gain = loss_before - loss_after return gain
# 示例G_L, H_L = 2.0, 3.0G_R, H_R = 1.0, 2.0G, H = 3.0, 5.0print(f"分裂增益: {xgboost_gain(G_L, H_L, G_R, H_R, G, H):.4f}")XGBoost在工程实现上的一个重要优化是预排序(Pre-sorting) 和 Block结构。
传统GBDT在寻找最佳分裂点时,每次都需要对特征值进行排序,时间复杂度高。XGBoost的做法是:
XGBoost的并行XGBoost的并行是特征维度的并行,而不是树维度的并行 —— 树与树之间仍然是串行训练的。
XGBoost的预排序算法虽然精确,但在大数据集上内存消耗大、计算开销高。LightGBM改用直方图算法,将连续特征离散化为有限个桶(bins) 。
算法流程:
算法优势:
| 优势 | 说明 |
|---|---|
| 计算复杂度降低 | 预排序算法复杂度为 ,直方图算法为 ,而 |
| 内存占用减少 | 只需存储离散的桶索引(可用 uint8_t 存储),无需存储预排序信息 |
| 直方图做差加速 | 父节点的直方图减去兄弟节点的直方图,即可得到当前节点的直方图 |
直方图做差(Histogram Subtraction)直方图做差 是LightGBM的一个精妙设计:在二叉树中,只要计算出左子节点的直方图,右子节点的直方图就可以通过 “父节点直方图 - 左子节点直方图” 快速得到,无需重新扫描数据。
代码实现:
import numpy as npfrom collections import defaultdict
class HistogramBasedSplitter: """直方图算法的简化实现"""
def __init__(self, n_bins=255): self.n_bins = n_bins
def build_histogram(self, feature_values, gradients, hessians): """构建直方图:将连续特征值分桶,统计每个桶的梯度和""" # 计算分桶边界 min_val, max_val = np.min(feature_values), np.max(feature_values) bin_width = (max_val - min_val) / self.n_bins
hist_g = np.zeros(self.n_bins) hist_h = np.zeros(self.n_bins) hist_count = np.zeros(self.n_bins)
for val, g, h in zip(feature_values, gradients, hessians): bin_idx = min(int((val - min_val) / bin_width), self.n_bins - 1) hist_g[bin_idx] += g hist_h[bin_idx] += h hist_count[bin_idx] += 1
return hist_g, hist_h, hist_count
def find_best_split(self, hist_g, hist_h, hist_count): """基于直方图寻找最佳分裂点""" total_g = np.sum(hist_g) total_h = np.sum(hist_h)
best_gain = -float('inf') best_bin = -1
left_g, left_h = 0, 0 for i in range(self.n_bins - 1): left_g += hist_g[i] left_h += hist_h[i] right_g = total_g - left_g right_h = total_h - left_h
# 计算分裂增益(XGBoost风格) gain = 0.5 * (left_g**2 / (left_h + 1e-6) + right_g**2 / (right_h + 1e-6) - total_g**2 / (total_h + 1e-6))
if gain > best_gain: best_gain = gain best_bin = i
return best_bin, best_gain在大规模数据集上,训练样本数量巨大,如何在不损失太多精度的前提下减少训练样本?GOSS(Gradient-based One-Side Sampling,基于梯度的单边采样) 是LightGBM的回答。
GOSS的核心思想:在GBDT中,梯度大的样本意味着当前模型对其预测误差大,需要重点学习;而梯度小的样本已经拟合得较好,对后续训练贡献有限。
GOSS的策略:
GOSS 伪代码:
输入:数据集 ,采样比例 (大梯度保留比例)、(小梯度采样比例),迭代次数
输出:训练好的提升树模型
极端情况:当 时GOSS退化为随机采样;当 时GOSS退化为全量训练
GOSS的巧妙之处它保留了“难样本”(大梯度),同时用加权的方式引入了“易样本”(小梯度)的信息,在保证精度的同时大幅减少了训练数据量。
EFB(Exclusive Feature Bundling,互斥特征捆绑) 是LightGBM的第三个核心技术。用于解决在 “高维稀疏数据中(如One-Hot编码后的类别特征),很多特征几乎不会同时取非零值 —— 它们是互斥的” 这一个问题。
EFB的核心思想:将这些互斥的特征捆绑(Bundle) 成一个新的特征,从而减少特征数量,加速训练。
EFB的数学化:
EFB有效的原因:稀疏数据中,互斥特征捆绑后,特征维度大幅降低,原本需要在 个特征上分别寻找分裂点,现在只需在 个捆绑特征上寻找()。LightGBM的实验显示,整体训练速度可提升20倍以上
XGBoost和LightGBM在树生长策略上的差异,是两者最直观的区别之一。
策略:从根节点开始,逐层扩展树 —— 先分裂当前层的所有节点,再进入下一层。
特点:
缺点:
策略:每次选择增益最大的叶子节点进行分裂,而不是按层统一分裂。
特点:
num_leaves 和 min_data_in_leaf)风险:
| 维度 | Level-wise (XGBoost) | Leaf-wise (LightGBM) |
|---|---|---|
| 生长方式 | 逐层分裂所有节点 | 每次选增益最大的叶子 |
| 树的平衡性 | 平衡 | 可能不平衡 |
| 收敛速度 | 较慢 | 更快 |
| 过拟合风险 | 较低 | 较高(需限制深度) |
| 参数敏感度 | 较低 | 较高 |
| 适用场景 | 小到中型数据 | 大规模数据 |
LightGBM通过 max_depth 参数来限制树的深度,防止leaf-wise策略导致的过拟合。
XGBoost和LightGBM都原生支持缺失值,无需预先填充。
XGBoost在训练过程中自动学习缺失值的默认分裂方向。
算法流程:
关键点:XGBoost的缺失值处理是数据驱动的——从训练数据中学习最优方向。
LightGBM在直方图算法中原生支持缺失值:
代码实现:
import xgboost as xgbimport lightgbm as lgbimport numpy as np
# XGBoost和LightGBM都默认支持缺失值X_train = np.array([[1, 2], [np.nan, 3], [4, np.nan], [5, 6]])y_train = np.array([0, 1, 0, 1])
# XGBoostxgb_model = xgb.XGBClassifier()xgb_model.fit(X_train, y_train) # 自动处理NaN
# LightGBMlgb_model = lgb.LGBMClassifier()lgb_model.fit(X_train, y_train) # 自动处理NaN
print("两者都原生支持缺失值,无需手动填充!")本质相同:两者都是从数据中学习缺失值的最优分配方向。
总结
维度 XGBoost LightGBM 提出时间 2014年 2017年 分裂算法 预排序 + Block 直方图算法 梯度利用 二阶泰勒展开(牛顿法) 一阶梯度(但有GOSS加速) 正则化 类似的正则化 树生长策略 Level-wise(按层) Leaf-wise(按叶子) 数据采样 列采样(特征子采样) GOSS(样本采样)+ EFB(特征捆绑) 缺失值处理 学习默认分裂方向 直方图特殊桶处理 类别特征 需预处理(One-Hot) 原生支持 内存占用 较高(预排序存储) 较低(直方图存储) 训练速度 较快 更快(特别是大数据) 适用场景 小到中型数据、需要稳定性 大规模数据、追求速度 核心要点回顾
- XGBoost的二阶泰勒展开:将损失函数展开到二阶,利用一阶梯度 和二阶梯度 共同决定分裂方向,收敛速度比传统GBM更快。正则化项 精确控制模型复杂度,防止过拟合。
- LightGBM的直方图算法:将连续特征离散化为有限个桶,将分裂查找复杂度从 降至 ,内存占用大幅降低。直方图做差进一步加速了训练。
- GOSS采样:保留所有大梯度样本(难样本),从小梯度样本中随机采样并加权,在保证精度的同时大幅减少训练数据量。
- EFB特征捆绑:将互斥的稀疏特征捆绑成一个特征,减少特征维度,加速训练。
- Level-wise vs Leaf-wise:XGBoost按层生长,树平衡稳定;LightGBM按叶子生长,每次选增益最大的叶子分裂,收敛更快但需防过拟合。
- 缺失值处理:两者都原生支持缺失值,从数据中学习最优的分配方向,无需手动填充。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章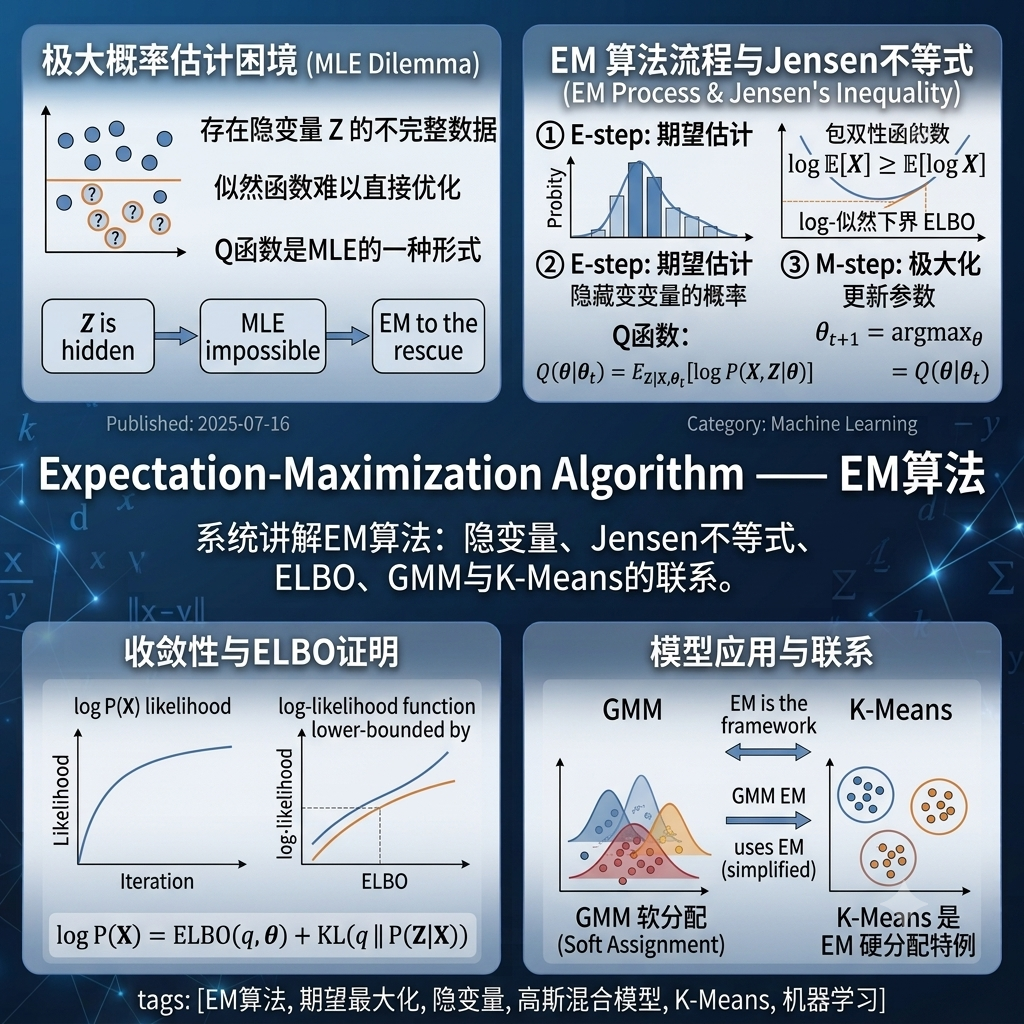
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章
系统讲解K-Means聚类的核心原理与算法细节,涵盖Lloyd交替优化算法的收敛性分析、K-Means作为EM算法特例的理论联系(硬分配 vs 软分配)、K-Means++初始化策略的D²采样机制与O(log K)近似保证,以及肘部法则与轮廓系数的选择K值方法及其局限。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面