


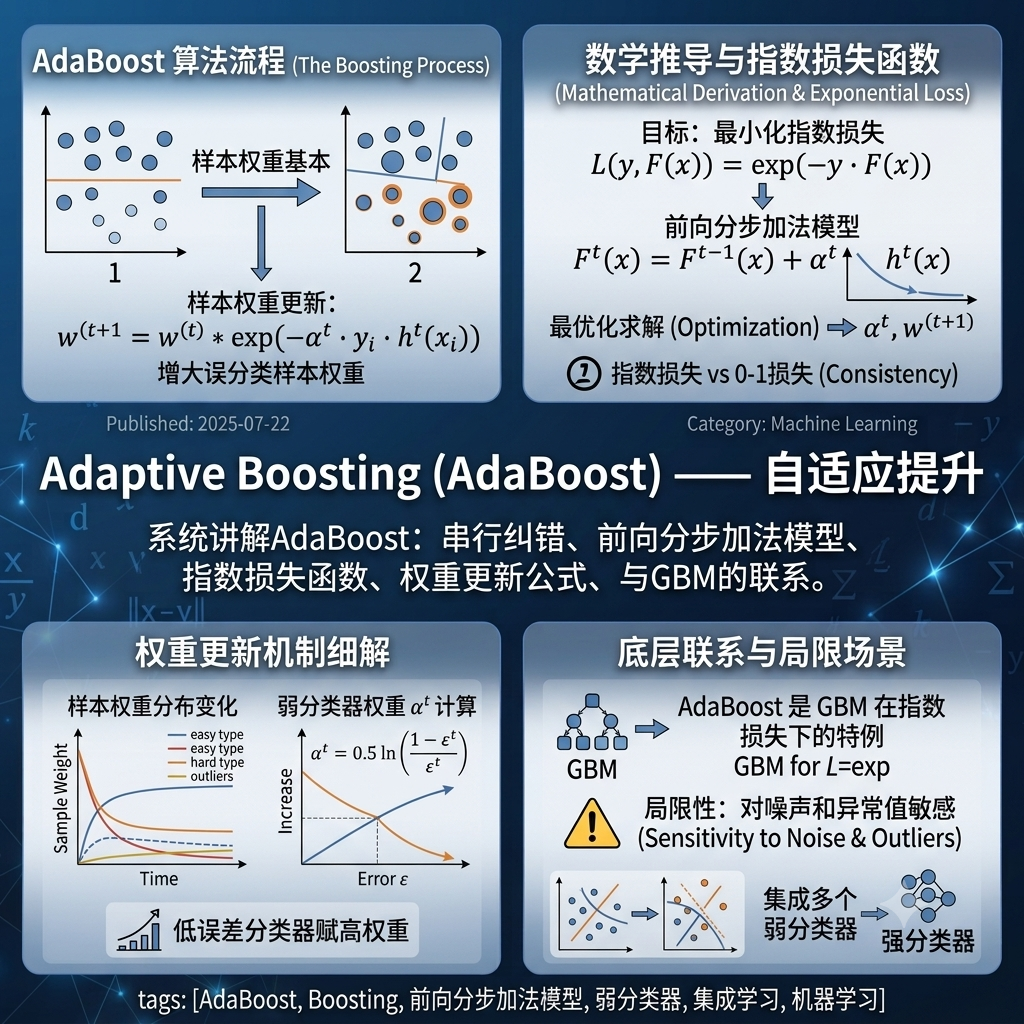
Adaptive Boosting (AdaBoost) —— 自适应提升
系统讲解AdaBoost算法的完整数学原理:从Boosting的串行纠错思想出发,推导前向分步加法模型与指数损失函数的等价性,通过最优化求解揭示弱分类器权重和样本权重更新公式的数学来源;深入分析指数损失与0-1损失的一致性及其对异常值的敏感性;阐明AdaBoost是GBM在指数损失下的特例这一底层联系。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
上一篇文章中,我们详细讨论了决策树的生长机制与剪枝策略,并指出它最核心的缺陷 —— 高方差。训练数据的微小扰动足以改变整棵树的结构,这种不稳定性使得单棵决策树在测试集上往往表现欠佳。然而,决策树的另一个特质 —— 低偏差,让它成为集成学习中极具潜力的基学习器。
集成学习(Ensemble Learning) 的核心思想正是利用这个矛盾:既然单棵树“强但脆弱”,那就构建多棵树并让它们共同决策。
Bagging(Bootstrap Aggregating) 是这一思想最直接的实现 —— 通过对训练数据进行 Bootstrap 自助采样生成多个有差异的训练子集,分别训练决策树,最后通过投票或平均聚合结果。这种“并行集成”的策略能够有效降低方差,其数学根源在于多个弱相关模型的平均化会压缩预测的波动范围。
随机森林在 Bagging 的基础上更进一步,引入了列采样(特征子空间)——每次分裂时只从随机选出的特征子集中寻找最优切分点。这种双重随机性(行采样 + 列采样) 进一步降低了树之间的相关性,使得方差降低的效果更为显著。
本文将从 Bootstrap 的数学原理出发,推导其样本覆盖率的来源,并通过偏差-方差分解解释 Bagging 为何能够降低方差而不增加偏差;随后深入随机森林的“双重随机性”机制,辨析两种特征重要性计算方法——基尼重要性(快速但有偏)与排列重要性(无偏但较慢)——的数学差异与适用场景。
Note读完本文,你将理解为何“随机”是森林成功的关键,也将掌握随机森林从训练到解释的完整方法论。
下一篇文章,我们将从并行集成转向串行集成——AdaBoost 将通过迭代调整样本权重的方式,让后续的树专注于修正前序模型的错误,开启“梯度提升”这一更强大的集成范式。
Bootstrap(自助法) 是一种强大的统计方法,用于从有限的样本中估计总体统计量(如均值、方差等)。
假设我们有一个包含 个样本的数据集 。Bootstrap采样的过程是:
这样我们就得到了一个Bootstrap样本集 ,它同样包含 个样本,但有些原始样本会出现多次,而有些则一次都不会出现。
对于原始数据集中的任意一个特定样本,在每次有放回抽样中不被选中的概率为:
经过 次独立抽样后,该样本从未被选中的概率为:
当 足够大时,利用极限 :
因此,该样本至少被选中一次的概率为:
结论:每个Bootstrap样本集平均包含原始数据集约63.2%的独特样本,剩下的约 36.8%从未出现在该Bootstrap样本中。这些未被选中的样本被称为袋外样本(Out-of-Bag, OOB) 。
代码实现:
import numpy as npimport matplotlib.pyplot as plt
def bootstrap_sampling_demo(n_samples=1000, n_bootstraps=1000): """演示Bootstrap采样中样本被选中的比例""" # 模拟:对每个Bootstrap样本,统计原始数据集中有多少个样本被选中 selected_counts = [] for _ in range(n_bootstraps): # 从0到n_samples-1中有放回地抽取n_samples次 sampled_indices = np.random.choice(n_samples, size=n_samples, replace=True) unique_selected = len(np.unique(sampled_indices)) selected_counts.append(unique_selected / n_samples)
mean_ratio = np.mean(selected_counts) print(f"平均选中比例: {mean_ratio:.4f}") print(f"理论值 (1 - 1/e): {1 - np.exp(-1):.4f}")
# 可视化 plt.hist(selected_counts, bins=30, edgecolor='black', alpha=0.7) plt.axvline(1 - np.exp(-1), color='red', linestyle='--', label='理论值 ≈ 0.632') plt.xlabel('被选中的独特样本比例') plt.ylabel('频次') plt.legend() plt.title('Bootstrap采样中独特样本的比例分布') plt.show()
bootstrap_sampling_demo()# 输出: 平均选中比例 ≈ 0.632, 与理论值高度一致Bagging(Bootstrap Aggregating) 的核心思想非常简单:
Bagging的关键优势在于降低方差(Variance Reduction) 。
假设我们有 个独立同分布的基学习器 ,每个学习器的预测方差为 。它们的平均预测的方差为:
由此可见:随着 增大,方差线性减小。
但在现实中,Bootstrap样本之间并非完全独立(因为它们是有放回地从同一数据集中采样的)。如果基学习器之间的相关性为 ,则平均预测的方差为:
当 时,方差趋近于 而非零。这说明基学习器之间的相关性越低,Bagging的方差降低效果越好。
这正是随机森林在Bagging基础上进一步引入列采样(特征随机子空间) 的原因 —— 降低树之间的相关性。
对于回归问题的偏差-方差分解,期望预测误差可以分解为:
Bagging通过平均多个模型来降低方差项,而不增加偏差。
随机森林在Bagging的基础上增加了一个关键的改进 —— 在每次分裂时,不是从所有特征中选择最佳分裂特征,而是从一个随机选择的特征子集中选择。
这形成了随机森林的双重随机性:
| 随机性来源 | 操作 | 目的 |
|---|---|---|
| 行采样(Bootstrap) | 每棵树使用不同的Bootstrap样本集 | 增加数据多样性 |
| 列采样(Feature Subspace) | 每次分裂时只考虑随机子集的特征 | 降低树间相关性 |
注意列采样也被称为随机子空间方法(Random Subspace Method) 或特征Bagging(Feature Bagging) 。
在scikit-learn中:
max_samples 和 bootstrap 控制max_features 控制max_features = sqrt(n_features)max_features = n_features假设特征总数为 ,每次分裂时随机选择 个特征()。如果两个特征高度相关,它们可能在不同的树中被选为分裂特征,从而产生相似的树结构。
列采样强制不同树使用不同的特征子集,增加了树之间的多样性。列采样通过降低树之间的相关性来进一步减小方差。
Breiman在原始随机森林论文中指出,森林的泛化误差取决于两个因素:
列采样在降低相关性(好处)的同时可能略微降低单棵树的强度(坏处),但总体效果是降低泛化误差。
从数学上看:随机森林 vs Bagging最近的研究表明,随机森林不仅降低方差,在某些情况下还能同时降低偏差 —— 当数据中存在某些模式时,随机森林能够捕捉到Bagging集成无法捕捉的模式,从而在降低方差的同时也降低偏差。
特别是当特征之间存在相关性时,随机森林的效果更为显著。
由于每个Bootstrap样本只包含约63.2%的原始样本,剩下的36.8%是袋外样本(Out-of-Bag, OOB) 。
对于第 个样本,如果它在第 棵树的Bootstrap样本中从未出现,那么第 棵树就可以用来验证第 个样本 —— 这相当于免费的交叉验证。
对于样本 ,定义:
其中 是那些没有使用样本 进行训练的树的索引。
OOB误差为:
其中 是损失函数(分类用0-1损失,回归用MSE)。
OOB误差是测试误差的无偏估计,而且不需要额外的验证集 —— 这是随机森林的一个巨大优势。
代码实现:
from sklearn.ensemble import RandomForestClassifierfrom sklearn.datasets import make_classificationfrom sklearn.model_selection import train_test_split
X, y = make_classification(n_samples=1000, n_features=20, random_state=42)X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)
rf = RandomForestClassifier(n_estimators=100, oob_score=True, random_state=42)rf.fit(X_train, y_train)
print(f"OOB Score: {rf.oob_score_:.4f}")print(f"Test Accuracy: {rf.score(X_test, y_test):.4f}")# OOB Score 与 Test Accuracy 通常非常接近这是随机森林默认的特征重要性计算方法。
数学原理:
在决策树的每个节点,分裂会带来不纯度的减少。对于分类树,不纯度用基尼指数(Gini Index) 衡量:
其中 是节点 中第 类样本的比例。
对于一个节点 按特征 分裂为左子节点 和右子节点 ,基尼减少量为:
特征 的重要性就是在所有树中,所有使用特征 进行分裂的节点的基尼减少量之和。
最后将所有特征的重要性归一化到 区间。
基尼重要性的局限性:对高基数特征(取值多的特征)有偏好;可能高估相关特征的重要性。
代码实现:
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.datasets import make_classification
# 生成数据:只有3个特征是有信息的X, y = make_classification( n_samples=1000, n_features=10, n_informative=3, n_redundant=0, n_repeated=0, random_state=42)
rf = RandomForestClassifier(n_estimators=100, random_state=42)rf.fit(X, y)
# 基尼重要性importances = rf.feature_importances_std = np.std([tree.feature_importances_ for tree in rf.estimators_], axis=0)
# 可视化plt.figure(figsize=(10, 6))indices = np.argsort(importances)[::-1]plt.bar(range(X.shape[1]), importances[indices], yerr=std[indices], capsize=5)plt.xticks(range(X.shape[1]), [f'Feature {i}' for i in indices])plt.xlabel('特征')plt.ylabel('基尼重要性')plt.title('随机森林特征重要性(基于基尼减少量)')plt.show()为了克服基尼重要性的偏差,另一种方法是排列重要性(Permutation Importance) 。
数学原理:
如果打乱某个特征后性能显著下降,说明该特征对模型很重要;如果性能几乎不变,说明该特征不重要。
排列重要性的优点:
代码实现:
from sklearn.inspection import permutation_importance
# 计算排列重要性result = permutation_importance( rf, X, y, n_repeats=10, # 每个特征打乱10次取平均 random_state=42)
perm_importances = result.importances_meanperm_std = result.importances_std
# 对比两种重要性plt.figure(figsize=(12, 5))
plt.subplot(1, 2, 1)plt.bar(range(X.shape[1]), importances)plt.title('基尼重要性')
plt.subplot(1, 2, 2)plt.bar(range(X.shape[1]), perm_importances)plt.title('排列重要性')
plt.tight_layout()plt.show()| 对比维度 | 基尼重要性 | 排列重要性 |
|---|---|---|
| 计算速度 | 快(训练时顺便计算) | 慢(需要额外计算) |
| 偏差 | 对高基数特征有偏好 | 无偏 |
| 模型依赖 | 仅适用于树模型 | 适用于任何模型 |
| 可解释性 | 间接(基于不纯度减少) | 直接(基于性能下降) |
| scikit-learn实现 | feature_importances_ | permutation_importance |
在机器学习中,泛化误差可以分解为三个部分:
决策树容易过拟合的根本原因 —— 对于单棵完全生长的决策树,低偏差能够完美拟合训练数据,高方差训练数据的微小变化会导致完全不同的树
Bagging通过平均多棵树的预测来降低方差:
其中 是树之间的相关性, 是单棵树的方差。
Bagging不改变偏差 —— 如果单棵树有偏差,Bagging后的偏差基本不变。
随机森林通过列采样进一步降低树之间的相关性,从而比Bagging获得更低的方差。
更令人惊讶的是,近年来的研究表明,随机森林在某些情况下还能降低偏差:随机森林能够捕捉到Bagging集成无法捕捉的数据模式,在降低方差的同时也降低偏差。特别是在信噪比(SNR)较高或特征之间存在相关性时,随机森林的这种优势更为明显。
效果对比
模型 偏差 方差 总体 单棵决策树 低 极高 过拟合 Bagging 不变(低) 降低 改善 随机森林 可能更低 进一步降低 最优 总结:随机森林 = Bagging(降低方差)+ 列采样(进一步降低相关性,可能同时降低偏差)。
import numpy as npimport pandas as pdfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.datasets import load_breast_cancerfrom sklearn.model_selection import train_test_split, cross_val_scorefrom sklearn.metrics import accuracy_score, classification_report
# 1. 加载数据data = load_breast_cancer()X, y = data.data, data.targetfeature_names = data.feature_names
X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.3, random_state=42)
# 2. 训练随机森林(调参示例)rf = RandomForestClassifier( n_estimators=100, # 树的数量 max_features='sqrt', # 列采样:sqrt(n_features) max_depth=10, # 预剪枝:限制深度 min_samples_split=10, # 预剪枝:最小分裂样本数 oob_score=True, # 计算OOB误差 random_state=42, n_jobs=-1 # 并行计算)rf.fit(X_train, y_train)
# 3. 评估print(f"训练集准确率: {rf.score(X_train, y_train):.4f}")print(f"测试集准确率: {rf.score(X_test, y_test):.4f}")print(f"OOB Score: {rf.oob_score_:.4f}")
# 4. 特征重要性分析importances = rf.feature_importances_indices = np.argsort(importances)[::-1]
print("\nTop 10 重要特征:")for i in range(10): print(f" {i+1}. {feature_names[indices[i]]}: {importances[indices[i]]:.4f}")
# 5. 交叉验证cv_scores = cross_val_score(rf, X, y, cv=5)print(f"\n5折交叉验证平均准确率: {cv_scores.mean():.4f} (+/- {cv_scores.std():.4f})")
# 6. 排列重要性(可选,计算较慢)from sklearn.inspection import permutation_importanceresult = permutation_importance(rf, X_test, y_test, n_repeats=10, random_state=42)print("\n排列重要性 Top 5:")top5_perm = np.argsort(result.importances_mean)[::-1][:5]for i in top5_perm: print(f" {feature_names[i]}: {result.importances_mean[i]:.4f} (+/- {result.importances_std[i]:.4f})")总结
概念 核心内容 Bootstrap 有放回抽样,每个样本被选中的概率 ≈ 63.2% Bagging Bootstrap + 聚合(投票/平均),降低方差 随机森林 Bagging + 列采样(特征子空间),进一步降低相关性 OOB误差 利用未被选中的样本做验证,免费的测试集 基尼重要性 累加所有树中特征分裂带来的基尼减少量,快速但有偏 排列重要性 打乱特征后观察性能下降,无偏但较慢 偏差-方差分解 随机森林降低方差,某些情况下也降低偏差 核心要点回顾
- Bootstrap自助采样是Bagging的基石。每个Bootstrap样本包含约63.2%的独特样本,剩下的36.8%成为袋外样本(OOB) ,可用于免费验证。
- Bagging通过对多个高方差模型(如决策树)的预测进行平均来降低方差,且不增加偏差。树之间的相关性越低,方差降低效果越好。
- 随机森林 = Bagging + 列采样(特征子空间) 。列采样进一步降低了树之间的相关性,使得方差降低效果更显著。在某些情况下,随机森林还能同时降低偏差。
- OOB误差是随机森林的“免费午餐” —— 无需额外的验证集就能获得测试误差的无偏估计。
- 特征重要性有两种主流计算方法:
- 基尼重要性:累加特征在所有树中分裂带来的不纯度减少,计算快速但可能对高基数特征有偏好
- 排列重要性:打乱特征后观察性能下降,计算较慢但更可靠、模型无关
- 偏差-方差分解揭示了随机森林成功的根源:通过Bootstrap和列采样的双重随机性,随机森林在保持低偏差的同时大幅降低了方差。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解AdaBoost算法的完整数学原理:从Boosting的串行纠错思想出发,推导前向分步加法模型与指数损失函数的等价性,通过最优化求解揭示弱分类器权重和样本权重更新公式的数学来源;深入分析指数损失与0-1损失的一致性及其对异常值的敏感性;阐明AdaBoost是GBM在指数损失下的特例这一底层联系。
阅读文章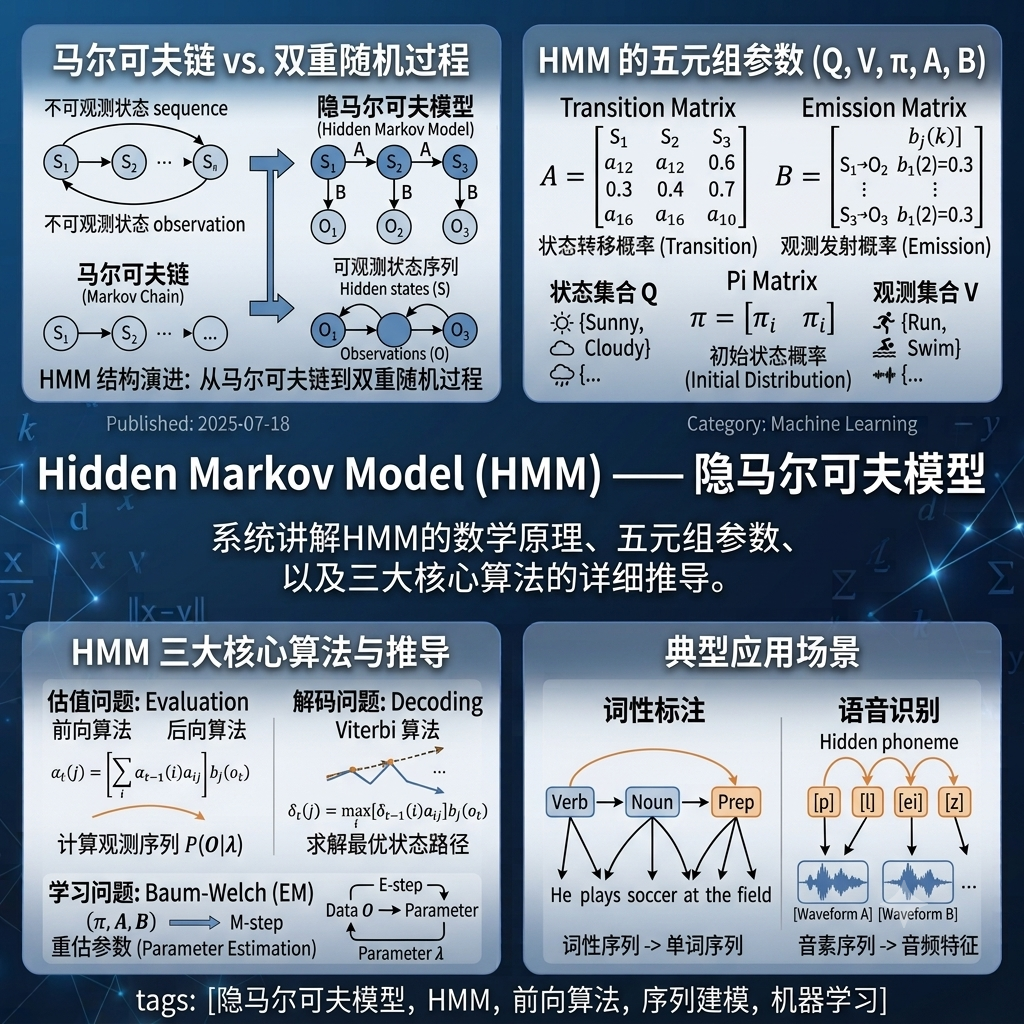
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章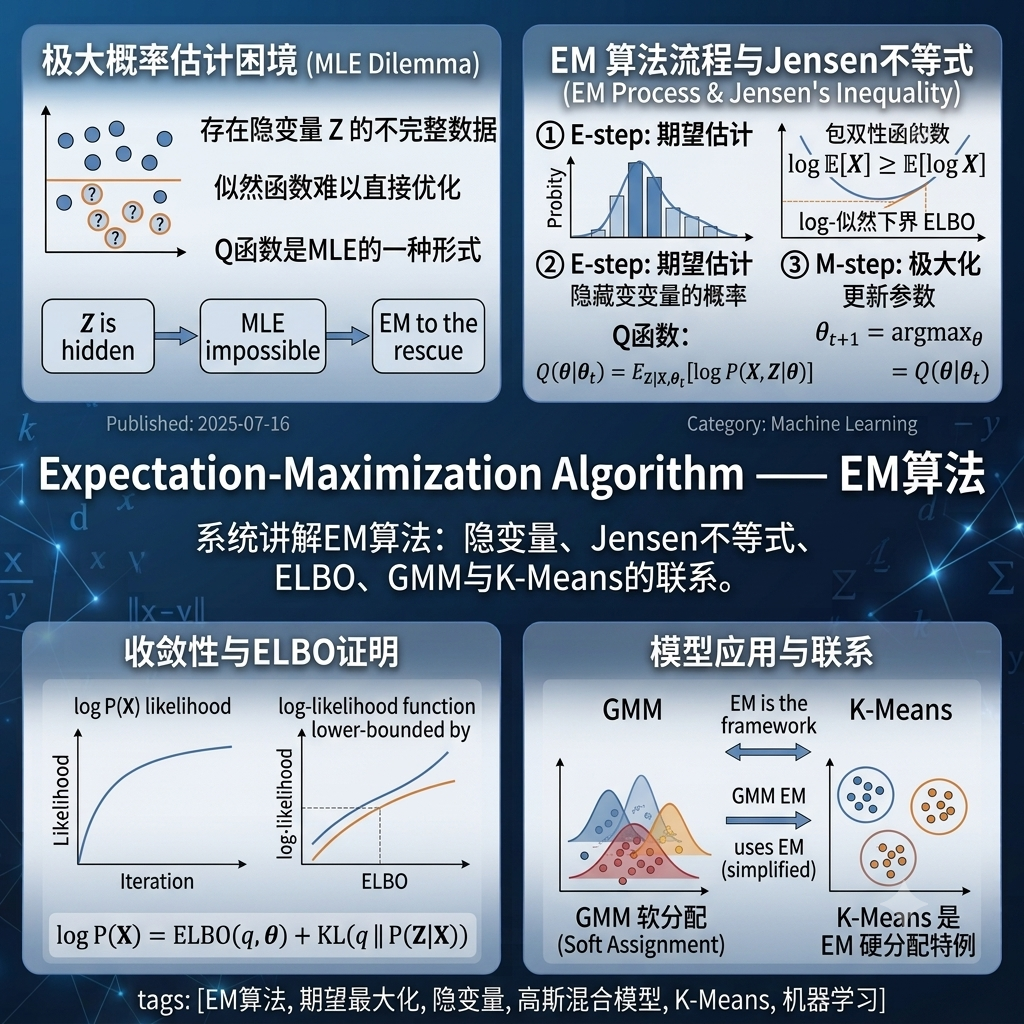
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面