


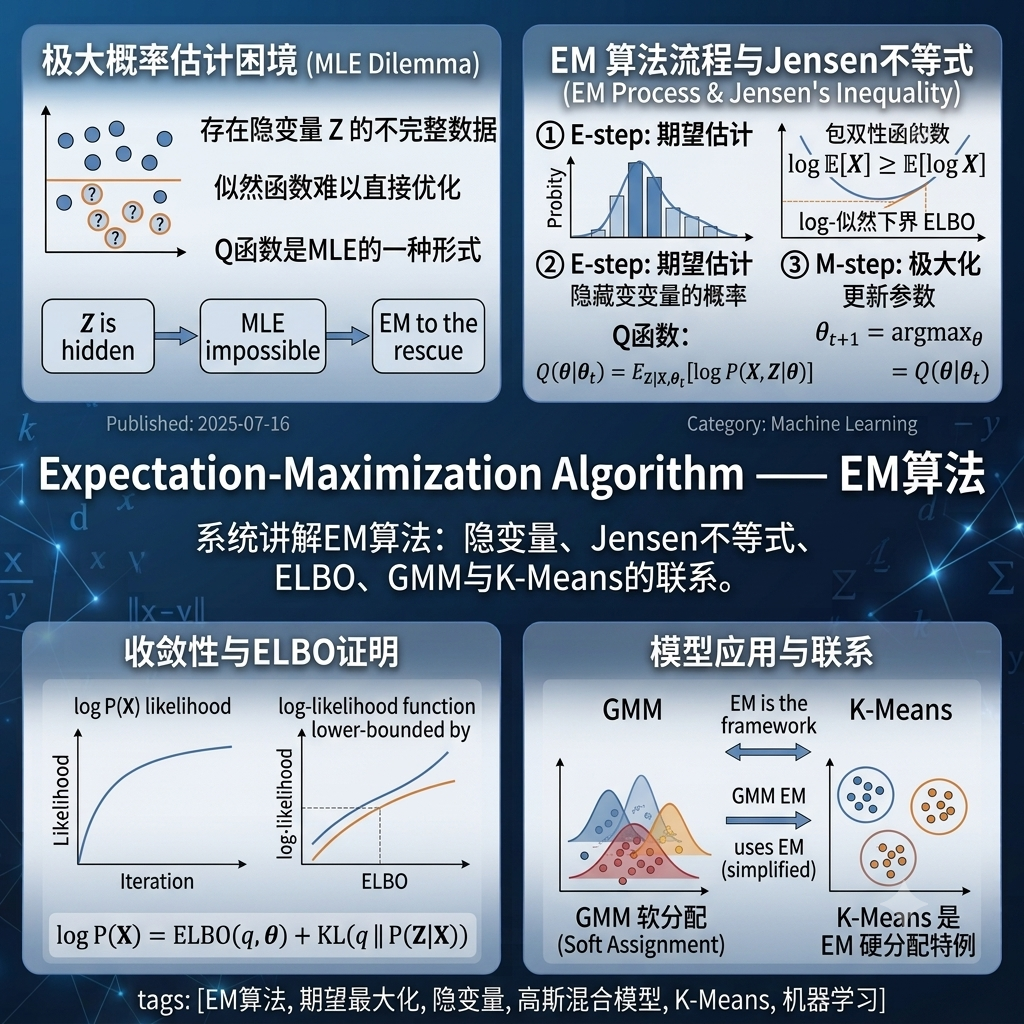
Expectation-Maximization Algorithm —— EM算法
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
上一篇文章中,我们讨论了 PCA(主成分分析) ——它通过寻找方差最大的正交方向,将数据投影到低维空间,实现了降维。PCA 的本质是从数据中提取“最主要的变化模式”,让高维数据变得可控。但降维只是无监督学习的一个侧面,另一个同样基本的问题是:数据中是否存在天然的分组结构?
K-Means 正是回答这个问题的经典算法,也是聚类领域最具代表性的方法之一。与 PCA 寻找“全局方差方向”不同,K-Means 的目标是将数据点划分为 个簇,使得每个点与其所属簇中心的距离平方和最小 —— 即最小化簇内距离、最大化簇间分离。
本文将从 Lloyd 交替优化算法出发,展示 K-Means 如何通过“分配—更新”两步迭代逐步降低目标函数,并证明其必然收敛(虽然只保证局部最优)。随后,我们将揭示 K-Means 与 EM 算法之间的深层联系——K-Means 本质上是以“硬分配”为极限的特例,对应于各向同性高斯混合模型在方差趋于零时的退化情形;理解这一关联有助于认清 K-Means 对球形簇的隐含假设。在初始化问题上,我们将剖析 K-Means++ 的 采样策略及其 近似保证。最后,本文将讨论选择 值的两种常用方法——肘部法则与轮廓系数——并明确指出肘部法则缺乏理论支撑的缺陷,以及轮廓系数在大规模数据上的计算瓶颈。
Note读完本文,你将掌握 K-Means 从直觉到算法再到理论分析的全貌,并理解它在无监督学习工具包中的正确定位:快速、直观,但假设苛刻。
作为第三阶段从降维到聚类的自然延伸,本文之后我们将进入 EM 算法 —— 届时 K-Means 的“硬分配”将被“软概率”所取代,迎来无监督学习中更强大的概率建模框架。
假设我们有一堆数据点,想将它们分成 个组(簇)。K-Means的直觉极其简单:
每个簇应该有一个“中心”,每个数据点应该属于离它最近的那个中心。
用数学语言来表达,K-Means的目标是最小化所有数据点到其所属簇中心的距离平方和:
其中:
这个目标函数 也被称为畸变(Distortion) 或惯量(Inertia) ——它衡量了簇的“紧密程度”:值越小,簇内的点越聚集。
这里的优化变量有两个:簇中心 和每个点的簇分配 。如果同时优化这两个变量,问题是一个NP难问题——没有多项式时间的精确解法。
既然不能同时优化,那就交替优化。Lloyd算法(即标准K-Means算法)采用了一个极其简单的迭代策略:
步骤1:初始化。随机选择 个数据点作为初始簇中心。
步骤2:重复以下两步直到收敛:
(a) 分配(Assignment) —— E步的“硬”版本:将每个数据点分配给离它最近的簇中心。
(b) 更新(Update) —— M步的“硬”版本:重新计算每个簇的中心(即簇内所有点的均值)。
其中 是分配给第 个簇的所有数据点的集合。
收敛判断:当簇中心不再发生变化(或变化小于某个阈值)时,算法停止。
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.datasets import make_blobs
class KMeans: """从零实现K-Means聚类算法(Lloyd算法)"""
def __init__(self, n_clusters=3, max_iter=300, random_state=None): self.n_clusters = n_clusters self.max_iter = max_iter self.random_state = random_state self.centroids = None self.labels_ = None self.inertia_ = None
def fit(self, X): np.random.seed(self.random_state) n_samples, n_features = X.shape
# 1. 初始化:随机选择K个样本作为初始中心 indices = np.random.choice(n_samples, self.n_clusters, replace=False) self.centroids = X[indices].copy()
for _ in range(self.max_iter): # 2a. 分配(E步):计算每个点到所有中心的距离,分配到最近的中心 distances = np.zeros((n_samples, self.n_clusters)) for k in range(self.n_clusters): distances[:, k] = np.linalg.norm(X - self.centroids[k], axis=1) labels = np.argmin(distances, axis=1)
# 2b. 更新(M步):重新计算每个簇的中心 new_centroids = np.zeros_like(self.centroids) for k in range(self.n_clusters): if np.sum(labels == k) > 0: new_centroids[k] = X[labels == k].mean(axis=0) else: # 如果某个簇没有分配到点,保持原中心不变(或重新初始化) new_centroids[k] = self.centroids[k]
# 检查是否收敛 if np.allclose(self.centroids, new_centroids, rtol=1e-4): break
self.centroids = new_centroids
# 计算最终的簇分配和惯量 distances = np.zeros((n_samples, self.n_clusters)) for k in range(self.n_clusters): distances[:, k] = np.linalg.norm(X - self.centroids[k], axis=1) self.labels_ = np.argmin(distances, axis=1) self.inertia_ = np.sum(np.min(distances, axis=1) ** 2)
return self
def predict(self, X): distances = np.zeros((X.shape[0], self.n_clusters)) for k in range(self.n_clusters): distances[:, k] = np.linalg.norm(X - self.centroids[k], axis=1) return np.argmin(distances, axis=1)
# 生成示例数据X, y_true = make_blobs(n_samples=300, centers=3, cluster_std=0.8, random_state=42)
# 训练K-Meanskmeans = KMeans(n_clusters=3, random_state=42)kmeans.fit(X)
print(f"收敛后的惯量: {kmeans.inertia_:.2f}")print(f"簇标签: {np.unique(kmeans.labels_, return_counts=True)}")Lloyd算法有一个重要的理论性质:它保证会收敛。
为什么?因为每一步都在单调地减小目标函数 :
由于 有下界,且每一步都在减小,算法最终必然收敛。
然而,这个收敛是局部最优的。Lloyd算法只能保证收敛到某个局部极小值,而不是全局最优。不同的初始中心会导致不同的聚类结果。
EM(Expectation-Maximization)算法是处理含有隐变量的概率模型参数估计的通用框架。
EM算法的核心思想是:
当数据中存在隐变量(未被观测到的变量)时,我们无法直接最大化似然函数。EM算法通过交替进行“猜测隐变量的分布”(E步)和“基于猜测更新参数”(M步),逐步逼近最大似然估计。
EM算法的标准流程:
E步(Expectation) :基于当前参数 ,计算隐变量的后验分布 。
M步(Maximization) :基于E步得到的隐变量分布,用最大似然估计更新参数 。
那么,K-Means和EM是什么关系?
K-Means可以看作是EM算法的一个特例。
让我们把K-Means套进EM的框架中:
| EM框架 | K-Means的对应物 |
|---|---|
| 隐变量 Z | 每个数据点的簇分配 (属于哪个簇) |
| 参数 | 簇中心 |
| E步 | 将每个点硬分配到最近的簇中心 |
| M步 | 用簇内点的均值更新簇中心 |
关键区别在于 “硬”vs“软” :
K-Means相当于假设高斯混合模型(GMM) 中每个高斯分量的协方差矩阵相同、各向同性(isotropic)、且方差趋于0。在这个极限情况下,后验概率退化为one-hot的硬分配,EM算法退化为K-Means。
从另一个角度来看,K-Means(Lloyd算法)可以看作是变分EM(Variational EM) 的一个特例,其中使用了截断后验(truncated posteriors) 作为变分分布。这种视角的一个重要优势是:不需要假设方差趋于0就能从理论上将K-Means与GMM联系起来。
# 对比:硬分配(K-Means风格)vs 软分配(GMM-EM风格)
def hard_assignment(points, centroids): """硬分配:每个点完全属于一个簇""" distances = np.array([[np.linalg.norm(p - c) for c in centroids] for p in points]) assignments = np.argmin(distances, axis=1) # 返回one-hot编码的硬分配 hard = np.zeros((len(points), len(centroids))) hard[np.arange(len(points)), assignments] = 1 return hard
def soft_assignment(points, centroids, variances): """软分配:每个点以概率属于各个簇(GMM风格)""" n_points, n_clusters = len(points), len(centroids) probs = np.zeros((n_points, n_clusters)) for k in range(n_clusters): # 计算每个点属于簇k的概率(假设高斯分布) diff = points - centroids[k] probs[:, k] = np.exp(-0.5 * np.sum(diff**2, axis=1) / variances[k]) # 归一化为概率分布 probs = probs / np.sum(probs, axis=1, keepdims=True) return probs
# 示例points = np.array([[0, 0], [1, 1], [10, 10]])centroids = np.array([[0, 0], [10, 10]])variances = np.array([1.0, 1.0])
print("硬分配(K-Means风格):")print(hard_assignment(points, centroids))# 输出: 前两个点属于簇0,最后一个点属于簇1
print("\n软分配(GMM-EM风格):")print(soft_assignment(points, centroids, variances))# 输出: 每个点有概率分布,如 [0.95, 0.05] 表示95%概率属于簇0K-Means和GMM-EM的对应关系揭示了一个重要的洞察:
K-Means是GMM-EM在“硬分配”极限下的特例。如果我们把“硬分配”放宽为“软分配”(即允许每个点以概率属于多个簇),就得到了高斯混合模型。
这个关系也解释了K-Means的一个核心假设:它假设所有簇都是球形且大小相近的。因为当所有高斯分量的协方差矩阵相同且各向同性时,决策边界是球形的——这正是K-Means用欧氏距离做最近邻分配所隐含的几何假设。
如果数据中的簇不是球形(比如拉长的椭圆),或者大小差异很大,K-Means的表现就会大打折扣。
Lloyd算法只能保证收敛到局部最优。不同的初始中心会导向完全不同的聚类结果。
一个糟糕的初始化可能导致:
传统的做法是:多次随机初始化,选择目标函数最小的结果。但这种方法计算量大,且不能保证找到好的初始点。
K-Means++ 由David Arthur和Sergei Vassilvitskii于2007年提出,它用一种概率采样的方式选择初始中心,使得初始中心尽可能分散。
K-Means++的初始化步骤:
步骤1:从数据点中均匀随机选择第一个簇中心 。
步骤2:对于每个数据点 ,计算它到最近已选中心的距离平方 。
步骤3:以与 成正比的概率选择下一个簇中心(即距离已有中心越远的点,被选中的概率越大)——这称为 采样(D²-sampling) 。
步骤4:重复步骤2-3,直到选出 个初始中心。
def kmeans_plusplus_init(X, n_clusters, random_state=None): """K-Means++初始化算法的简化实现""" np.random.seed(random_state) n_samples, n_features = X.shape
# 步骤1:随机选择第一个中心 centroids = [X[np.random.choice(n_samples)]]
# 步骤2-4:迭代选择剩余的中心 for _ in range(1, n_clusters): # 计算每个点到最近已选中心的距离平方 distances = np.array([ min([np.linalg.norm(x - c) ** 2 for c in centroids]) for x in X ]) # 按概率(与距离平方成正比)选择下一个中心 probs = distances / np.sum(distances) next_idx = np.random.choice(n_samples, p=probs) centroids.append(X[next_idx])
return np.array(centroids)
# 对比:随机初始化 vs K-Means++X, _ = make_blobs(n_samples=300, centers=3, cluster_std=0.8, random_state=42)
# 随机初始化random_init = X[np.random.choice(len(X), 3, replace=False)]print("随机初始化中心:\n", random_init)
# K-Means++初始化kpp_init = kmeans_plusplus_init(X, 3, random_state=42)print("\nK-Means++初始化中心:\n", kpp_init)# K-Means++的中心通常更分散,覆盖数据的各个区域K-Means++最吸引人的地方在于它的理论保证:
K-Means++能够以 的近似比逼近最优聚类代价。
通俗地说:K-Means++找到的初始中心,其对应的聚类代价(目标函数值)不会比全局最优值差太多——差距被控制在 倍以内。
这就是为什么scikit-learn的KMeans默认使用init='k-means++'——它用一个简单的概率采样策略,显著提高了找到高质量聚类的概率。
K-Means要求用户预先指定簇的数量 ——但在实际问题中,我们往往不知道数据应该分成几类。这就引出了聚类中最棘手的问题之一:如何选择 ?
肘部法则的思路很直观:
为什么畸变会随 增加而下降?因为簇越多,每个点离自己的中心就越近。但增加的簇带来的畸变下降会逐渐减小——那个“拐点”就是肘部。
from sklearn.cluster import KMeans
def elbow_method(X, max_k=10): """肘部法则:计算不同K值下的惯量""" inertias = [] K_range = range(1, max_k + 1)
for k in K_range: kmeans = KMeans(n_clusters=k, random_state=42, n_init=10) kmeans.fit(X) inertias.append(kmeans.inertia_)
# 绘制肘部曲线 plt.figure(figsize=(8, 5)) plt.plot(K_range, inertias, 'bo-') plt.xlabel('簇的数量 K') plt.ylabel('惯量 (Inertia)') plt.title('肘部法则') plt.grid(True) plt.show()
return inertias
# 生成数据并应用肘部法则X, _ = make_blobs(n_samples=300, centers=4, cluster_std=0.6, random_state=42)inertias = elbow_method(X, max_k=10)# 观察:曲线在K=4处出现明显的“肘部”肘部法则有一个致命的弱点:它严重缺乏理论支撑。有研究者甚至呼吁 “停止使用肘部法则” 。
肘部法则的主要问题:
问题一:主观性强。 什么是“肘部”?不同的人可能看到不同的拐点。在很多数据集上,畸变曲线是平滑下降的,根本没有明显的肘部。
问题二:对数据分布敏感。 当数据分布不均匀、有噪声、或簇的形状不是球形时,肘部法则的结果往往不可靠。
问题三:缺乏理论保证。 肘部法则只是一个启发式规则,没有任何统计理论保证它选择的 是最优的。
轮廓系数由Rousseeuw于1987年提出,它衡量的是每个点与自身簇的紧密程度相对于与最近邻簇的分离程度。
对于第 个数据点,轮廓系数的计算分为三步:
步骤1:计算 —— 点 到同簇内其他点的平均距离(簇内凝聚度)。
步骤2:计算 —— 点 到最近的其他簇中所有点的平均距离(簇间分离度)。
步骤3:计算轮廓系数:
轮廓系数的取值范围是 :
通常,轮廓系数 > 0.7 表示聚类质量很好。
from sklearn.metrics import silhouette_score
def silhouette_analysis(X, max_k=10): """轮廓系数分析:计算不同K值下的平均轮廓系数""" scores = [] K_range = range(2, max_k + 1) # 轮廓系数至少需要2个簇
for k in K_range: kmeans = KMeans(n_clusters=k, random_state=42, n_init=10) labels = kmeans.fit_predict(X) score = silhouette_score(X, labels) scores.append(score)
# 绘制轮廓系数曲线 plt.figure(figsize=(8, 5)) plt.plot(K_range, scores, 'ro-') plt.xlabel('簇的数量 K') plt.ylabel('平均轮廓系数') plt.title('轮廓系数分析') plt.axhline(y=0.7, color='green', linestyle='--', label='高质量聚类 (0.7)') plt.legend() plt.grid(True) plt.show()
return scores
# 应用轮廓系数分析scores = silhouette_analysis(X, max_k=10)# 选择轮廓系数最高的K值best_k = np.argmax(scores) + 2print(f"最佳K值: {best_k}, 轮廓系数: {scores[best_k-2]:.4f}")轮廓系数也有其局限:
计算开销大。 轮廓系数需要计算所有点对之间的距离,复杂度为 。对于大规模数据集,计算可能非常耗时。
对簇形状敏感。 和K-Means一样,轮廓系数假设簇是凸的、球形的。对于非凸形状的簇,轮廓系数可能给出误导性的结果。
没有绝对标准。 虽然0.7被视为“好”的阈值,但这个阈值是经验性的,不是理论保证的。
基于以上的讨论,这里给出一些更可靠的选择K的方法:
| 方法 | 优点 | 缺点 |
|---|---|---|
| 领域知识 | 最可靠 | 并非总有领域知识 |
| 肘部法则 | 简单直观 | 主观、缺乏理论支撑 |
| 轮廓系数 | 有明确的统计解释 | 计算量大 |
| Gap Statistic | 有统计理论支撑 | 计算复杂 |
| 下游任务评估 | 最实用 | 需要定义具体任务 |
最实际的做法:结合多种方法,并用下游任务(如分类、异常检测)的绩效来验证聚类结果的有效性。毕竟,聚类的最终目的是服务于某个实际任务。
理解K-Means的隐式假设,是正确使用它的前提:
假设一:簇是球形的(Spherical) 。K-Means使用欧氏距离,决策边界是超球面。如果数据中的簇是拉长的、椭圆的或任意形状的,K-Means可能表现不佳。
假设二:簇的大小相近(Equal Size) 。K-Means倾向于产生大小相近的簇。如果一个簇很大、另一个很小,大簇可能会“吞掉”小簇的部分点。
假设三:簇的密度相近(Equal Density) 。K-Means的分配基于距离,如果不同簇的密度差异很大,密度高的簇会被过度分割。
K-Means最适合以下场景:
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.datasets import make_blobs, make_circles, make_moonsfrom sklearn.cluster import KMeansfrom sklearn.metrics import silhouette_score, adjusted_rand_scorefrom sklearn.preprocessing import StandardScaler
# 1. 生成不同形状的数据np.random.seed(42)
# 数据集1:球形簇(K-Means擅长)X1, y1 = make_blobs(n_samples=500, centers=4, cluster_std=0.6, random_state=42)
# 数据集2:环形数据(K-Means不擅长)X2, y2 = make_circles(n_samples=500, factor=0.5, noise=0.05, random_state=42)
# 数据集3:月牙形数据(K-Means不擅长)X3, y3 = make_moons(n_samples=500, noise=0.05, random_state=42)
# 2. 标准化(K-Means对尺度敏感)scaler = StandardScaler()X1_scaled = scaler.fit_transform(X1)X2_scaled = scaler.fit_transform(X2)X3_scaled = scaler.fit_transform(X3)
# 3. 对三个数据集运行K-Meansfig, axes = plt.subplots(2, 3, figsize=(15, 8))datasets = [(X1_scaled, y1, '球形簇'), (X2_scaled, y2, '环形数据'), (X3_scaled, y3, '月牙形数据')]
for idx, (X, y_true, title) in enumerate(datasets): # 运行K-Means kmeans = KMeans(n_clusters=4 if idx == 0 else 2, random_state=42, n_init=10) labels = kmeans.fit_predict(X)
# 可视化 ax = axes[0, idx] ax.scatter(X[:, 0], X[:, 1], c=labels, cmap='viridis', alpha=0.6) ax.scatter(kmeans.cluster_centers_[:, 0], kmeans.cluster_centers_[:, 1], c='red', marker='X', s=200, label='簇中心') ax.set_title(f'{title}\nK-Means聚类结果') ax.legend()
# 评估 ax2 = axes[1, idx] ax2.scatter(X[:, 0], X[:, 1], c=y_true, cmap='viridis', alpha=0.6) ax2.set_title(f'{title}\n真实标签')
# 打印指标 sil_score = silhouette_score(X, labels) ari_score = adjusted_rand_score(y_true, labels) print(f"{title}: 轮廓系数={sil_score:.4f}, ARI={ari_score:.4f}")
plt.tight_layout()plt.show()
# 结论:K-Means在球形簇上表现优异,在环形和月牙形数据上表现较差| 概念 | 核心内容 |
|---|---|
| Lloyd算法 | 交替执行“分配”(E步)和“更新”(M步),保证收敛到局部最优 |
| 目标函数 | ,即畸变(Distortion)/惯量(Inertia) |
| K-Means与EM | K-Means是EM的特例——硬分配 + 各向同性高斯 |
| 硬分配 vs 软分配 | K-Means做硬分配(每个点100%属于一个簇),GMM-EM做软分配(概率分配) |
| K-Means++ | 用 采样选择分散的初始中心,有 的近似保证 |
| 肘部法则 | 绘制 -畸变曲线找“肘部”,缺乏理论支撑,不推荐作为唯一依据 |
| 轮廓系数 | ,>0.7表示聚类质量好 |
| K-Means的假设 | 簇是球形的、大小相近、密度相近 |
Lloyd算法是K-Means的标准实现,通过交替优化簇分配和簇中心来最小化畸变。算法保证收敛,但只能收敛到局部最优。
K-Means是EM算法的特例——它相当于用硬分配(而非软分配)来处理高斯混合模型,且假设所有高斯分量的协方差矩阵相同且各向同性。理解这个联系,就能理解K-Means的局限性:它只适用于球形、大小相近的簇。
K-Means++通过概率采样( 采样)选择分散的初始中心,显著提高了找到高质量聚类的概率,且有 的理论保证。
肘部法则虽然有“肘部”这个直观概念,但严重缺乏理论支撑。轮廓系数提供了更具体的统计解释,但计算开销大。在实践中,应结合多种方法,并以下游任务的表现来验证聚类结果。
K-Means的适用场景是球形、大小相近、密度相近的簇。如果数据不满足这些假设(如环形、拉长、密度差异大),应考虑DBSCAN、谱聚类或GMM等其他算法。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章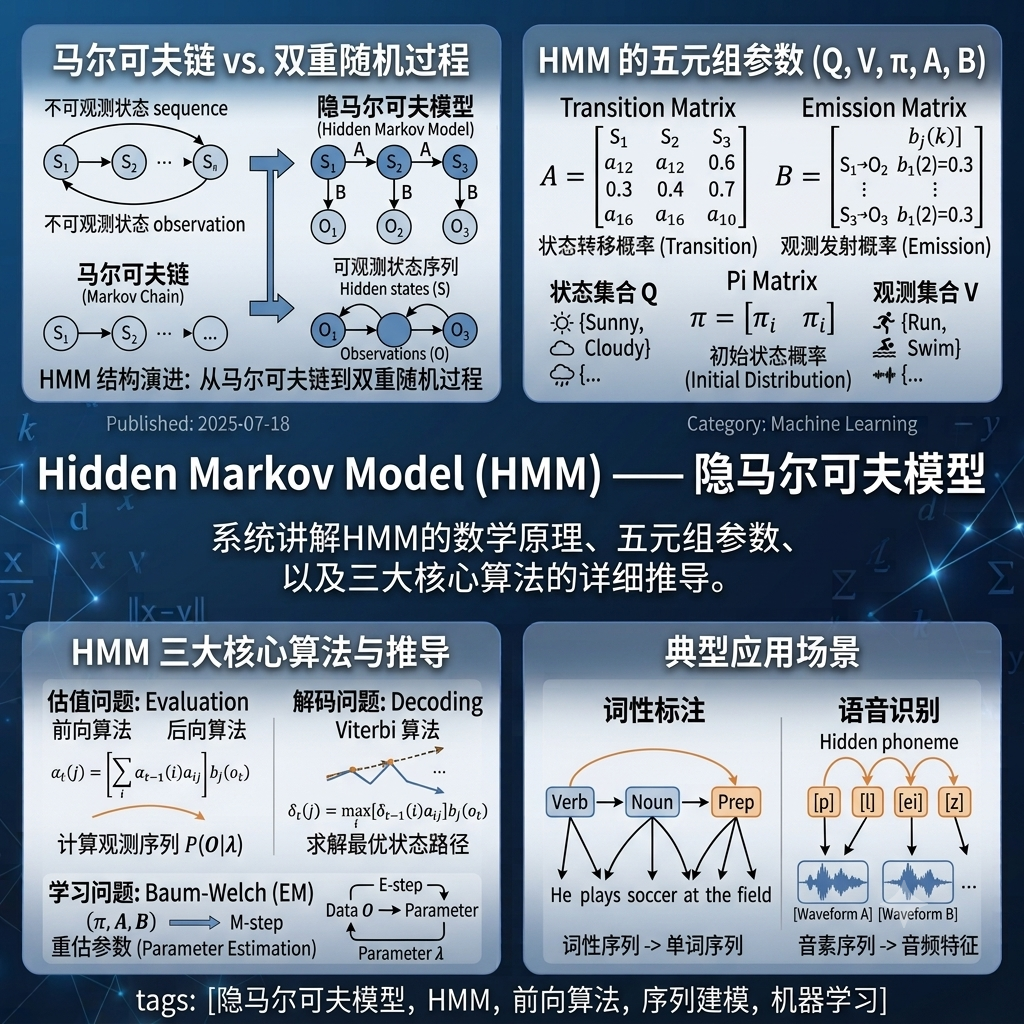
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章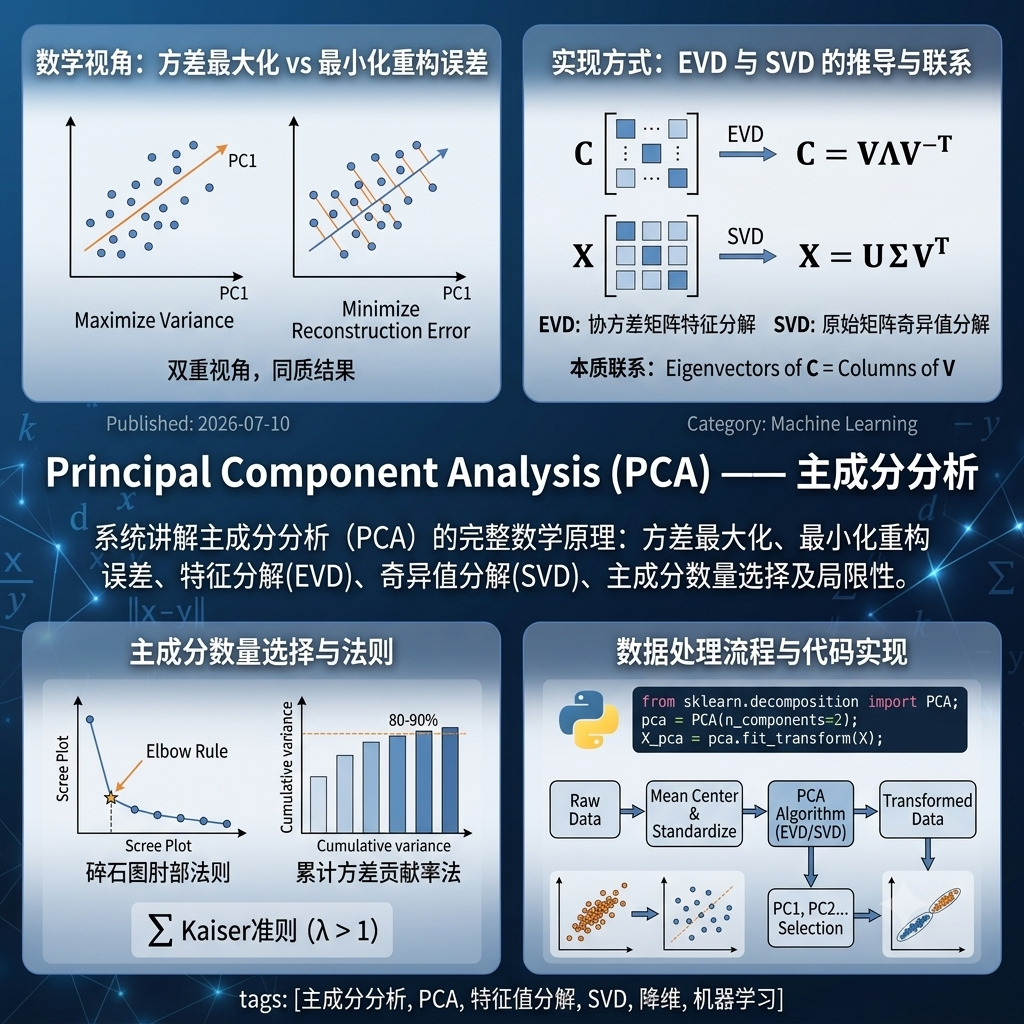
系统讲解主成分分析(PCA)的完整数学原理:从方差最大化与最小化重构误差两个等价视角出发,通过拉格朗日乘子法推导出协方差矩阵的特征方程,揭示特征向量即主成分方向、特征值即主成分方差的本质联系;深入对比EVD与SVD两种实现方式的优劣与适用场景;详细介绍三种主成分数量选择方法;讨论PCA的假设和局限。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面