



K-Means Clustering —— 聚类算法
系统讲解K-Means聚类的核心原理与算法细节,涵盖Lloyd交替优化算法的收敛性分析、K-Means作为EM算法特例的理论联系(硬分配 vs 软分配)、K-Means++初始化策略的D²采样机制与O(log K)近似保证,以及肘部法则与轮廓系数的选择K值方法及其局限。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
上一篇文章中,我们详细讨论了 K-Means——它通过“分配—更新”两步交替迭代,将数据点划分为 个簇。K-Means 的实现简洁到令人惊叹:分配步骤将每个点硬性划归最近的簇中心,更新步骤重新计算簇内均值。这种“硬分配”策略虽然高效,却也暴露了一个根本性的局限:它无法表达不确定性 —— 一个位于两个簇边界的数据点,要么属于 A,要么属于 B,没有中间状态。
现实数据中的不确定性无处不在。当两个高斯分布重叠时,一个观测点可能以 60% 的概率来自分布 A、40% 的概率来自分布 B——这种“软归属”信息在硬分配中被完全丢弃了。EM 算法(Expectation-Maximization) 正是为这种场景而生的通用框架,它由 Dempster、Laird 和 Rubin 于 1977 年正式提出,是处理含隐变量概率模型参数估计的最经典方法。
EM 算法的核心逻辑可以概括为两步迭代:E 步(Expectation)在给定当前参数下计算隐变量的后验分布 —— 即“软分配”的概率;M 步(Maximization)基于这些软分配权重重新估计模型参数。这一框架的理论根基在于 Jensen 不等式所构造的 ELBO(证据下界) —— E 步让下界紧贴目标函数,M 步提升下界,从而间接提升似然函数。本文将用二硬币模型展示 EM 的直观计算流程,再用高斯混合模型(GMM) 展示其在连续数据上的完整推导,最后揭示一个贯穿始终的联系:K-Means 是 EM 在“硬分配”极限下的特例,对应于各向同性高斯混合模型在方差趋于零时的退化情形。
Note读完本文,你将掌握 EM 算法的完整数学框架,并理解它为何是统计学和机器学习中最具影响力的方法论之一。至此,我们从 K-Means 的“硬聚类”走到了 GMM-EM 的“软聚类”,从确定性分配走向了概率建模。
下一篇文章,我们将进入 HMM(隐马尔可夫模型) —— 它将 EM 的思想延伸到序列数据,引入时间维度的隐变量结构,完成第三阶段从“独立同分布”到“时序依赖”的最后一跃。
在进入EM算法之前,先快速回顾一下极大似然估计(Maximum Likelihood Estimation, MLE) 。
假设我们有一个概率模型,其参数为 ,观测数据为 。MLE的目标是找到一组参数 ,使得观测数据出现的概率最大。
似然函数为:
为了计算方便,通常取对数,得到对数似然函数:
MLE的估计值为:
当模型简单时(如单个高斯分布、二项分布等),我们可以直接对 求导并令导数为零,得到解析解。
现在考虑一个更复杂的情况:数据中存在隐变量 ,我们观测不到 ,只能观测到 。
此时,似然函数变成:
或者对于连续隐变量:
对数似然为:
注意看:对数和求和的位置颠倒了。
这就是隐变量带来的核心困境:边际似然函数中的“和的对数”无法直接优化。
让我们用一个经典例子来感受这个困境。
假设有两枚硬币A和B,它们抛出正面的概率分别是 和 ,但我们不知道。我们做了5轮实验,每轮随机选择一枚硬币,抛10次,记录正面次数。
情况一:我们知道每轮用的是哪枚硬币
| 轮次 | 硬币 | 正面次数 |
|---|---|---|
| 1 | A | 5 |
| 2 | A | 9 |
| 3 | B | 4 |
| 4 | A | 4 |
| 5 | B | 5 |
这种情况下,没有隐变量。我们可以直接估计:
情况二:我们不知道每轮用的是哪枚硬币
| 轮次 | 硬币 | 正面次数 |
|---|---|---|
| 1 | ? | 5 |
| 2 | ? | 9 |
| 3 | ? | 4 |
| 4 | ? | 4 |
| 5 | ? | 5 |
现在,“每轮用的是哪枚硬币”就是隐变量 。我们只知道观测数据 (每轮的正面次数),却不知道 。
如果我们想用MLE估计 和 ,需要最大化:
这个式子中的求和(对所有可能的硬币分配组合)使得直接优化变得极其困难。这就是EM算法要解决的问题。
回到二硬币模型。我们陷入了一个循环困境:
EM算法的解决思路为先随便猜一个,然后交替迭代。
E步(Expectation Step,期望步骤):基于当前的参数估计 ,计算完整数据对数似然 在隐变量后验分布 下的期望。
数学上,E步构造如下函数:
也就是说:
这个 函数是EM算法的核心。它不是原始的似然函数,而是完整数据对数似然的期望。
M步(Maximization Step,最大化步骤):寻找使 函数最大化的新参数:
函数通常比原始的边际似然容易最大化——在 函数中,隐变量 已经被积分掉了(通过期望),剩下的只是关于 的优化问题,而且往往有解析解。
EM算法的数学基础是 Jensen不等式。对于凹函数 (如 函数),Jensen不等式告诉我们:
现在,我们想最大化 。引入任意一个关于隐变量 的分布 :
关于上述变换的说明
:任意一个关于隐变量 的概率分布(满足 ,且 )。
数学技巧:原式是 ,乘以一个 ,拆成了 。
目的:这一步是为了把求和伪装成数学期望。因为 正好是一个概率权重,所以 就等于“在 这个分布下,对括号里的值求期望”。
由于 是凹函数,应用Jensen不等式:
右边这个量被称为 ELBO(Evidence Lower Bound) ——证据下界:
ELBO与对数似然之间有一个重要的关系:
其中 是KL散度,衡量两个分布之间的差异,恒为非负。
ELBO与对数似然之间的重要关系数学推导这个等式不是凭空冒出来的,它是贝叶斯公式的简单代数变形。
联合分布可以拆解为:
两边同时取对数:
两边同时在分布 下取期望 :
把 单独拎到左边,整理一下:
在右边巧妙地加一项、减一项 (恒等变形):
第一项正好就是 ELBO,第二项正好就是 。
于是,得到ELBO与对数似然之间的重要关系式:
因此:
当且仅当 时,KL散度为0,ELBO等于对数似然。
从ELBO的视角来看,EM算法的两步实际上是在交替优化两个变量:
这个视角揭示了EM算法的本质:它通过交替优化ELBO,逐步提升对数似然的下界,从而间接提升对数似然本身。
EM算法最优雅的性质是它保证每次迭代后观测数据的对数似然不会下降。即
证明概要:
在E步中,选择 ,此时ELBO等于对数似然:
在M步中,最大化 函数(即ELBO):
由ELBO的定义,对于任意 :
特别地:
因此:
ImportantEM算法保证收敛到局部最优(似然函数的局部最大值),但不保证收敛到全局最优。不同的初始值可能导致不同的局部最优解。
回到二硬币模型。我们有5轮实验,每轮抛10次,但不知道用的是哪枚硬币:
| 轮次 | 正面次数 |
|---|---|
| 1 | 5 |
| 2 | 9 |
| 3 | 4 |
| 4 | 4 |
| 5 | 5 |
目标是估计 和 。
初始化:,
第1轮:
Tip以第一轮(5正5反)为例:
- 如果是硬币A:
- 如果是硬币B:
归一化后:
同理计算其他轮次。
Tip以硬币A为例,它“贡献”的正面次数 = 各轮正面次数 × 该轮来自A的概率之和。
计算得到新参数:
import numpy as np
def em_coin(observations, theta_A, theta_B, max_iter=100, tol=1e-6): """ 二硬币模型的EM算法 observations: 每轮实验的正面次数(假设每轮抛10次) theta_A, theta_B: 初始参数 """ n_rounds = len(observations) n_flips = 10 # 每轮抛10次
for t in range(max_iter): # E步:计算每轮来自A和B的概率 prob_A = np.zeros(n_rounds) prob_B = np.zeros(n_rounds)
for i, heads in enumerate(observations): tails = n_flips - heads # 在给定参数下,出现该观测结果的概率 p_A = (theta_A ** heads) * ((1 - theta_A) ** tails) p_B = (theta_B ** heads) * ((1 - theta_B) ** tails) prob_A[i] = p_A / (p_A + p_B) prob_B[i] = p_B / (p_A + p_B)
# M步:更新参数 # 硬币A的期望正面次数和期望总次数 expected_heads_A = np.sum(prob_A * observations) expected_total_A = np.sum(prob_A * n_flips) theta_A_new = expected_heads_A / expected_total_A
expected_heads_B = np.sum(prob_B * observations) expected_total_B = np.sum(prob_B * n_flips) theta_B_new = expected_heads_B / expected_total_B
# 检查收敛 if abs(theta_A_new - theta_A) < tol and abs(theta_B_new - theta_B) < tol: print(f"收敛于第 {t+1} 轮迭代") break
theta_A, theta_B = theta_A_new, theta_B_new print(f"第 {t+1} 轮: θA={theta_A:.4f}, θB={theta_B:.4f}")
return theta_A, theta_B
# 运行EM算法observations = [5, 9, 4, 4, 5] # 每轮正面次数theta_A, theta_B = em_coin(observations, 0.6, 0.5)print(f"\n最终结果: θA={theta_A:.4f}, θB={theta_B:.4f}")高斯混合模型(Gaussian Mixture Model, GMM) 是EM算法最经典的应用场景。
GMM假设数据由 个高斯分布混合而成。每个数据点 的生成过程是:
其中 是混合系数(), 和 是第 个高斯分量的均值和协方差矩阵。
隐变量是每个数据点 来自哪个高斯分量——这个信息无法观测。
完整数据的对数似然为:
其中 表示第 个点是否属于第 个分量。
E步:计算后验概率
M步:更新参数
import numpy as npimport matplotlib.pyplot as pltfrom scipy.stats import multivariate_normal
class GMM: """高斯混合模型(使用EM算法)"""
def __init__(self, n_components=3, max_iter=100, tol=1e-6): self.n_components = n_components self.max_iter = max_iter self.tol = tol self.pi = None # 混合系数 self.mu = None # 均值 self.sigma = None # 协方差矩阵 self.gamma = None # 后验概率(责任)
def _initialize(self, X): """初始化参数(使用K-Means++思想)""" n_samples, n_features = X.shape
# 初始化均值:随机选择K个样本 indices = np.random.choice(n_samples, self.n_components, replace=False) self.mu = X[indices].copy()
# 初始化协方差:单位矩阵 self.sigma = np.array([np.eye(n_features) for _ in range(self.n_components)])
# 初始化混合系数:均匀分布 self.pi = np.ones(self.n_components) / self.n_components
def _e_step(self, X): """E步:计算后验概率""" n_samples = X.shape[0] self.gamma = np.zeros((n_samples, self.n_components))
for k in range(self.n_components): # 计算每个点属于第k个分量的概率密度 rv = multivariate_normal(mean=self.mu[k], cov=self.sigma[k]) self.gamma[:, k] = self.pi[k] * rv.pdf(X)
# 归一化 self.gamma = self.gamma / np.sum(self.gamma, axis=1, keepdims=True)
def _m_step(self, X): """M步:更新参数""" n_samples, n_features = X.shape
# 更新混合系数 N_k = np.sum(self.gamma, axis=0) self.pi = N_k / n_samples
# 更新均值 for k in range(self.n_components): self.mu[k] = np.sum(self.gamma[:, k:k+1] * X, axis=0) / N_k[k]
# 更新协方差 for k in range(self.n_components): diff = X - self.mu[k] weighted_diff = self.gamma[:, k:k+1] * diff self.sigma[k] = (weighted_diff.T @ diff) / N_k[k] # 加小值保证正定 self.sigma[k] += 1e-6 * np.eye(n_features)
def fit(self, X): """训练GMM""" self._initialize(X)
prev_log_likelihood = -np.inf
for t in range(self.max_iter): # E步 self._e_step(X)
# M步 self._m_step(X)
# 计算对数似然 log_likelihood = 0 for i in range(X.shape[0]): likelihood = 0 for k in range(self.n_components): rv = multivariate_normal(mean=self.mu[k], cov=self.sigma[k]) likelihood += self.pi[k] * rv.pdf(X[i]) log_likelihood += np.log(likelihood + 1e-10)
if abs(log_likelihood - prev_log_likelihood) < self.tol: print(f"GMM收敛于第 {t+1} 轮迭代") break
prev_log_likelihood = log_likelihood
return self
def predict(self, X): """预测每个点最可能属于的簇""" self._e_step(X) return np.argmax(self.gamma, axis=1)
def predict_proba(self, X): """预测每个点属于每个簇的概率""" self._e_step(X) return self.gamma
# 生成数据np.random.seed(42)n_samples = 300
# 三个高斯分量X1 = np.random.multivariate_normal([0, 0], [[1, 0.5], [0.5, 1]], n_samples // 3)X2 = np.random.multivariate_normal([5, 5], [[1, -0.3], [-0.3, 1]], n_samples // 3)X3 = np.random.multivariate_normal([0, 5], [[0.5, 0], [0, 0.5]], n_samples // 3)X = np.vstack([X1, X2, X3])
# 训练GMMgmm = GMM(n_components=3, max_iter=100)gmm.fit(X)labels = gmm.predict(X)
# 可视化plt.figure(figsize=(10, 6))plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='viridis', alpha=0.6)plt.scatter(gmm.mu[:, 0], gmm.mu[:, 1], c='red', marker='X', s=200, label='簇中心')plt.title('GMM聚类结果(EM算法)')plt.legend()plt.axis('equal')plt.show()在后续的文章中,我们会详细介绍K-Means算法。我们可以从EM的视角审视它 —— K-Means可以看作是EM算法的一个特例。
| EM框架 | K-Means | GMM-EM |
|---|---|---|
| 隐变量 | 簇分配 | 簇分配 |
| 参数 | 簇中心 | 均值 、协方差 、混合系数 |
| E步 | 硬分配:每个点100%属于最近的簇 | 软分配:每个点以概率属于各簇 |
| M步 | 用簇内点的均值更新中心 | 用加权平均更新所有参数 |
关键区别:K-Means做的是硬分配(Hard Assignment) —— 每个数据点只能属于一个簇;而GMM-EM做的是软分配(Soft Assignment) —— 每个数据点可以以一定的概率属于多个簇。
从数学上看,K-Means等价于GMM的一个特殊情形:当所有高斯分量的协方差矩阵 (各向同性且相同)且 时,后验概率 退化为 one-hot 向量,GMM-EM 退化为 K-Means。
| 对比维度 | K-Means(硬分类) | GMM(软分类) |
|---|---|---|
| 分配方式 | 每个点属于一个簇 | 每个点以概率属于各簇 |
| 不确定性表达 | 无法表达 | 概率分布表达不确定性 |
| 簇形状 | 仅限球形 | 可以处理任意椭圆形状 |
| 簇大小 | 假设大小相近 | 可以处理不同大小的簇 |
| 对重叠数据的处理 | 差 | 好(概率分配自然处理重叠) |
| 计算复杂度 | 低 | 较高 |
在真实数据中,簇与簇之间往往存在重叠。一个数据点可能部分属于簇A、部分属于簇B——比如一个身高175cm的人,既有可能是男生也有可能是女生。
K-Means的硬分配无法表达这种不确定性。而GMM的软分配通过概率自然地表达了这种不确定性,这种软分配不仅更符合真实情况,还避免了硬分配中“边界点”的尴尬 —— 边界点不会被迫完全属于某一个簇,而是以概率分布在多个簇之间。
总结
概念 核心内容 隐变量困境 边际似然 中的“和的对数”难以直接优化 E步 计算 M步 ELBO $\log p(X 收敛性 EM保证每一步似然函数不下降,但只能收敛到局部最优 K-Means EM的硬分配特例() GMM EM的软分配经典应用,可处理任意椭圆形状的簇 核心要点回顾
- 隐变量的困境:当模型包含隐变量时,边际似然 中的“和的对数”无法直接优化。EM算法通过迭代的方式绕开了这个困难。
- E步与M步:E步计算完整数据对数似然在隐变量后验分布下的期望(即 函数),M步最大化这个期望来更新参数。两步交替进行,逐步逼近最优解。
- ELBO与收敛性:EM算法的数学基础是Jensen不等式,它保证ELBO始终是边际对数似然的下界。每一步M步都在提升ELBO,从而间接提升对数似然。EM算法保证收敛,但只能收敛到局部最优。
- K-Means是EM的特例:K-Means相当于GMM-EM在硬分配极限下的退化版本。K-Means做硬分类(每个点100%属于一个簇),GMM做软分类(每个点以概率属于各簇)。软分类能更好地处理簇重叠和不确定性。
- EM算法的本质:EM与其说是一种具体的算法,不如说是一种解决问题的框架。它不限定具体的模型——可以是GMM、HMM、LDA等——只要模型包含隐变量,都可以用EM框架来求解。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解K-Means聚类的核心原理与算法细节,涵盖Lloyd交替优化算法的收敛性分析、K-Means作为EM算法特例的理论联系(硬分配 vs 软分配)、K-Means++初始化策略的D²采样机制与O(log K)近似保证,以及肘部法则与轮廓系数的选择K值方法及其局限。
阅读文章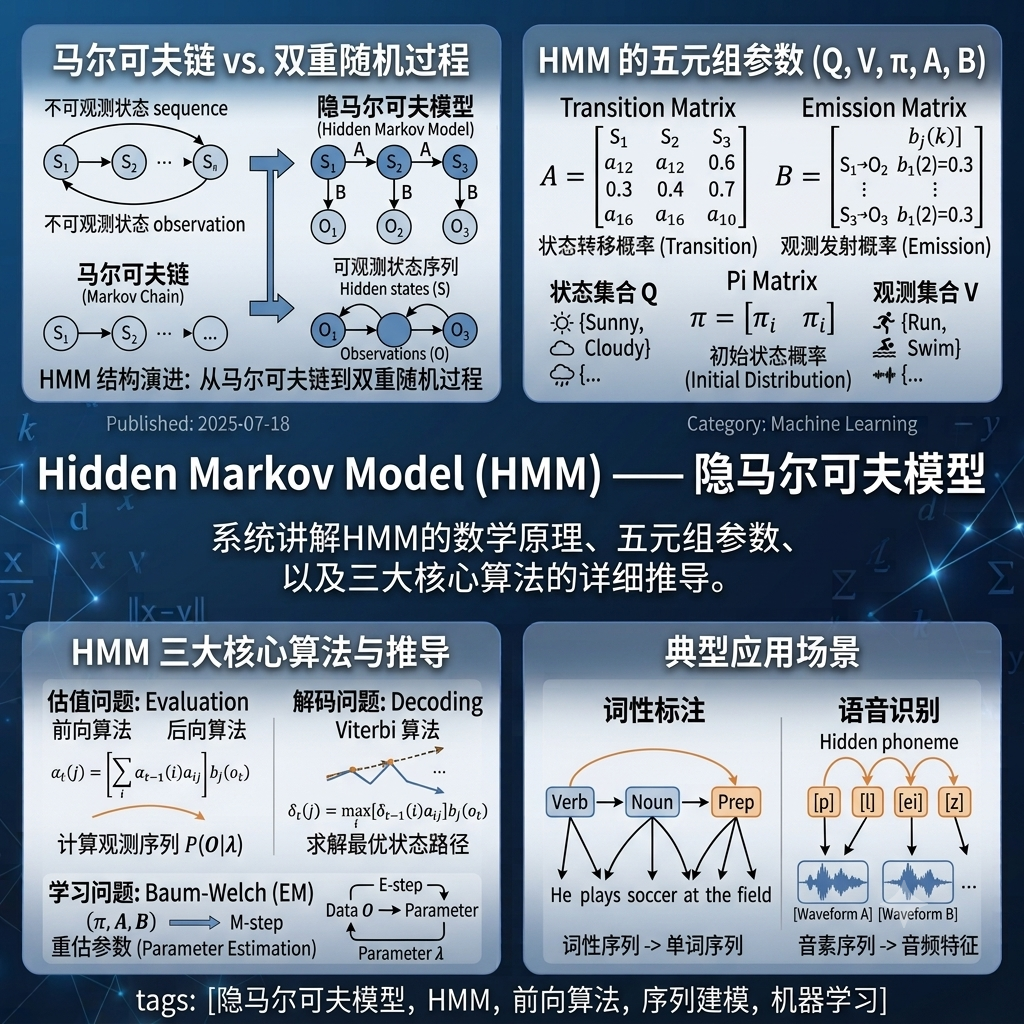
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章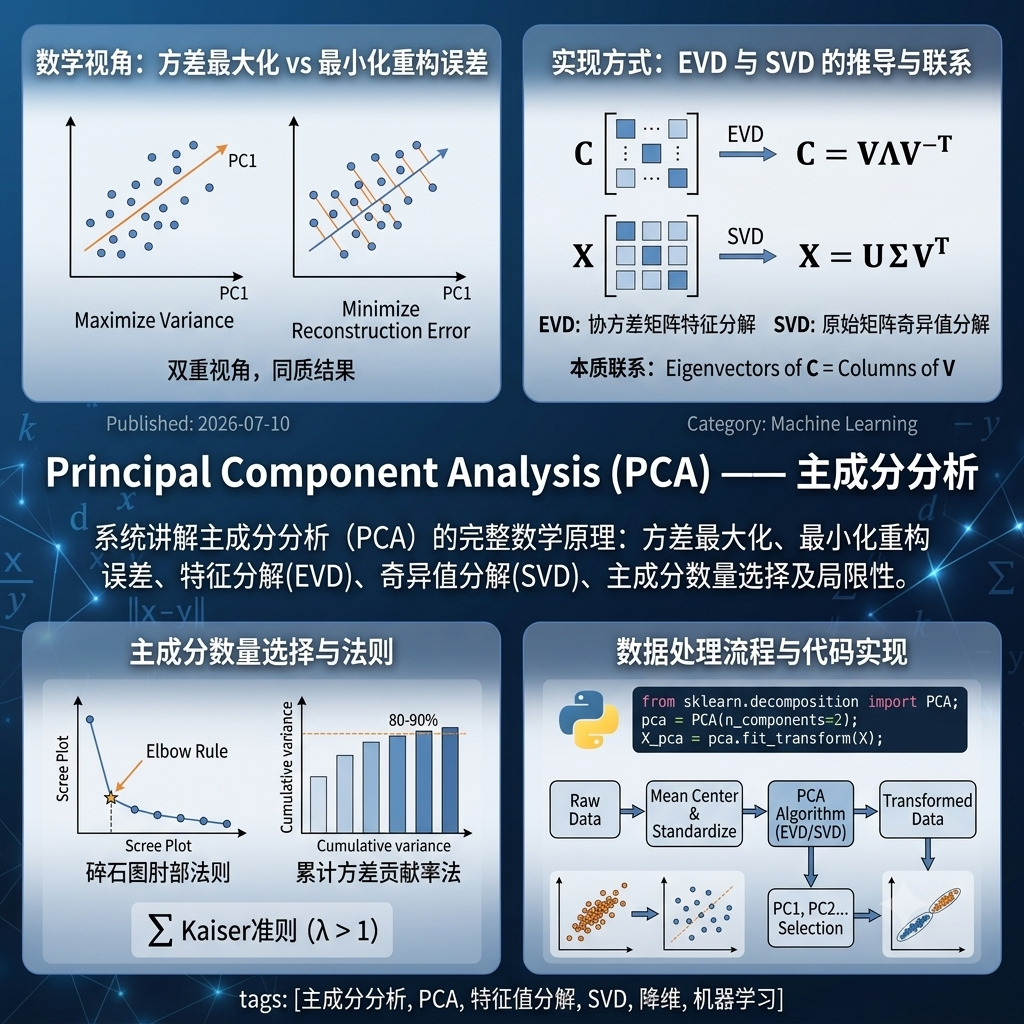
系统讲解主成分分析(PCA)的完整数学原理:从方差最大化与最小化重构误差两个等价视角出发,通过拉格朗日乘子法推导出协方差矩阵的特征方程,揭示特征向量即主成分方向、特征值即主成分方差的本质联系;深入对比EVD与SVD两种实现方式的优劣与适用场景;详细介绍三种主成分数量选择方法;讨论PCA的假设和局限。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面