


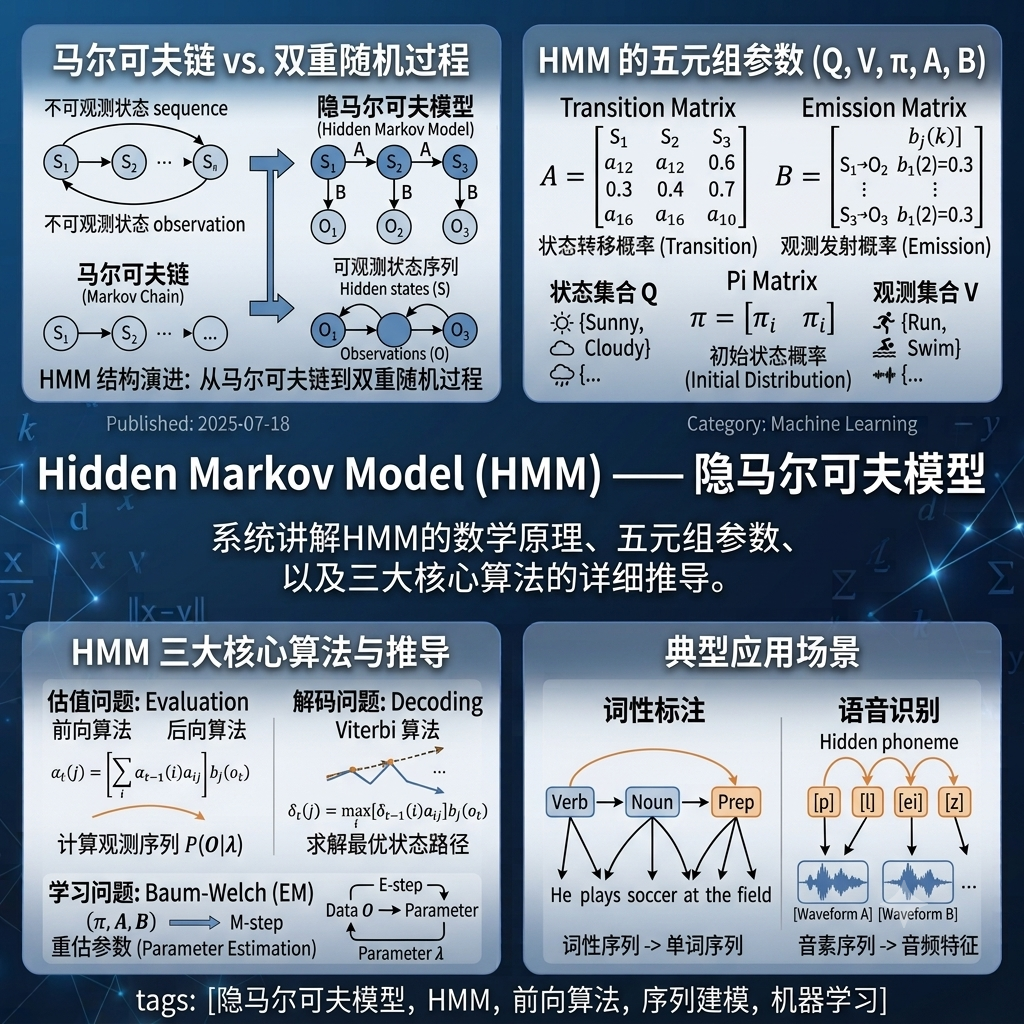
Hidden Markov Model (HMM) —— 隐马尔可夫模型
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
如果说线性回归是回归任务的基石,那么逻辑回归就是分类任务的基石。分类问题遍布现实世界的各个角落——判断邮件是否为垃圾邮件、识别用户是否点击广告、区分肿瘤良恶性——它们的共同点是:输出不再是一个连续数值,而是一个离散的类别标签。
逻辑回归的核心思想并不复杂:在线性回归的基础上,套一层 Sigmoid 函数,将连续的 压缩到 区间,使其可以被解释为概率。但真正让逻辑回归在统计和机器学习领域站稳脚跟的,是它的对数几率(Log Odds) 解释 —— 模型本质上是在用线性函数去逼近“正负类概率之比”的对数,这赋予了模型极强的可解释性。
在损失函数的设计上,逻辑回归与线性回归走上了分岔路。线性回归使用均方误差,逻辑回归则基于最大似然估计推导出交叉熵损失 —— 这一区别并非随意为之,而是由预测函数的改变(从线性输出变成概率输出) 所决定的。
本文将从 Sigmoid 的函数特性出发,完整推导二分类逻辑回归的损失函数与梯度,并自然延伸至 Softmax 回归(多分类的逻辑推广),同时给出 Log-Sum-Exp 数值稳定性技巧这一工程落地的关键细节。在多分类评价环节,我们将辨析 宏平均与微平均 F1-Score 的适用差异 —— 前者平等对待每个类别,适合不平衡数据;后者平等对待每个样本,适合关注整体准确性的场景。
Note本文延续了线性回归中“损失函数设计 + 优化求解”的分析框架,但你会发现:预测函数的改变驱动了损失函数、优化方法和评价体系的全面重构——这正是机器学习中“模型选择”的本质。
下一篇我们将进入 KNN,迎来第一个非参数化模型,彻底告别参数优化的范式。
线性回归的输出是一个连续值,取值范围是 。而二分类问题的输出是离散的类别标签,比如 。
如果我们直接用线性回归 去拟合 0/1 标签,会遇到两个问题 —— 预测值可能远超出 [0, 1] 区间,无法解释为概率;模型对异常值极其敏感
因此,我们需要一个映射函数,将线性回归的输出 压缩到 区间,使其可以解释为概率。
最常用的映射函数就是 Sigmoid 函数(也叫 Logistic 函数):
它的图像是一个优美的 S 形曲线,具有以下重要性质:
这个导数特性非常关键——它意味着我们可以根据函数值直接计算导数值,而不需要额外的计算,在梯度下降中效率极高。代码示例如下:
import numpy as npimport matplotlib.pyplot as plt
def sigmoid(z): return 1 / (1 + np.exp(-z))
def sigmoid_derivative(z): s = sigmoid(z) return s * (1 - s)
z = np.linspace(-10, 10, 100)plt.plot(z, sigmoid(z), label='σ(z)')plt.plot(z, sigmoid_derivative(z), label="σ'(z)", linestyle='--')plt.axhline(0.5, color='gray', linestyle=':')plt.axvline(0, color='gray', linestyle=':')plt.xlabel('z')plt.ylabel('value')plt.legend()plt.title('Sigmoid 函数及其导数')plt.show()逻辑回归的模型假设是:
其中 表示在给定参数 和输入 的条件下,样本属于正类(y=1) 的概率:
将两个式子统一写成:
几率(Odds) 是指事件发生的概率与不发生的概率之比:
对几率取自然对数,得到对数几率(Log Odds) ,也叫 Logit:
将 代入:
Important这就是逻辑回归被称为“对数几率回归”的原因 —— 模型实际上是用线性回归 去逼近真实标签的对数几率。
从上面的推导可以看出:
因此,决策边界就是 这条线(或超平面)。
观察到逻辑回归的决策边界本质上是线性的。如果数据本身不是线性可分的,我们需要通过特征工程(如添加多项式特征、交互特征)来构造非线性决策边界。
代码示例:
from sklearn.datasets import make_classificationfrom sklearn.linear_model import LogisticRegression
# 生成二分类数据X, y = make_classification(n_samples=200, n_features=2, n_redundant=0, n_clusters_per_class=1, random_state=42)
# 训练逻辑回归model = LogisticRegression()model.fit(X, y)
# 决策边界: θ0 + θ1*x1 + θ2*x2 = 0 => x2 = -(θ0 + θ1*x1) / θ2coef = model.coef_[0]intercept = model.intercept_[0]# 绘制决策边界...在线性回归中,我们通过最小化均方误差(MSE) 来求解参数。但在逻辑回归中,MSE 不再是凸函数,用梯度下降容易陷入局部最优。
因此,逻辑回归采用最大似然估计(Maximum Likelihood Estimation, MLE) 来估计参数。
给定训练集 ,其中 。
根据模型假设,每个样本的概率为:
假设样本之间独立同分布,则似然函数为所有样本概率的乘积:
直接最大化乘积不方便(容易数值下溢),取对数将乘积变为求和:
机器学习中习惯最小化损失函数,所以在对数似然前加负号,得到交叉熵损失(Cross-Entropy Loss) :
对 求偏导:
具体推导:定义:
链式法则:
单样本损失:
求偏导:
代入 :
化简:
对所有样本取平均得:
这个形式与线性回归的梯度形式极其相似!区别仅在于线性回归的预测值是 ,而逻辑回归的预测值是 。
梯度下降更新公式:
代码实现:
class LogisticRegressionGD: """使用梯度下降的逻辑回归"""
def __init__(self, learning_rate=0.01, n_iterations=1000): self.lr = learning_rate self.n_iterations = n_iterations self.theta = None
def sigmoid(self, z): return 1 / (1 + np.exp(-z))
def fit(self, X, y): n_samples, n_features = X.shape X_b = np.c_[np.ones((n_samples, 1)), X] # 添加截距项 self.theta = np.zeros(n_features + 1)
for _ in range(self.n_iterations): z = X_b @ self.theta h = self.sigmoid(z) gradient = (1 / n_samples) * (X_b.T @ (h - y)) self.theta -= self.lr * gradient
self.intercept_ = self.theta[0] self.coef_ = self.theta[1:] return self
def predict_proba(self, X): X_b = np.c_[np.ones((X.shape[0], 1)), X] return self.sigmoid(X_b @ self.theta)
def predict(self, X, threshold=0.5): return (self.predict_proba(X) >= threshold).astype(int)当类别数 时,二分类逻辑回归无法直接使用。有两种常见的处理策略:
Softmax 回归是逻辑回归在多分类问题上的自然推广。它假设类别之间互斥(每个样本只属于一个类别)。
给定 个类别的得分(logits),Softmax 函数将其转换为概率分布:
Softmax 的输出满足概率分布的两个性质 —— 每个输出在 (0, 1) 之间,所有输出之和为 1
在 Softmax 回归中,每个类别 有自己的权重向量 ,得分 :
对于多分类问题,标签 。用独热编码(One-Hot Encoding) 表示:如果样本属于类别 ,则 ,其余为 0。
似然函数为:
取负对数,得到多分类交叉熵损失:
对 求梯度:
这个形式与二分类逻辑回归的梯度完全一致——只是从 2 类扩展到了 K 类。
代码实现:
class SoftmaxRegression: """使用梯度下降的Softmax回归"""
def __init__(self, learning_rate=0.01, n_iterations=1000): self.lr = learning_rate self.n_iterations = n_iterations self.theta = None
def softmax(self, Z): # Z: (n_samples, K) exp_Z = np.exp(Z - np.max(Z, axis=1, keepdims=True)) # 数值稳定 return exp_Z / np.sum(exp_Z, axis=1, keepdims=True)
def fit(self, X, y): n_samples, n_features = X.shape self.classes = np.unique(y) self.K = len(self.classes)
# 将标签转为独热编码 y_onehot = np.eye(self.K)[y]
X_b = np.c_[np.ones((n_samples, 1)), X] self.theta = np.zeros((n_features + 1, self.K))
for _ in range(self.n_iterations): scores = X_b @ self.theta # (n_samples, K) probs = self.softmax(scores) gradient = (1 / n_samples) * (X_b.T @ (probs - y_onehot)) self.theta -= self.lr * gradient
self.intercept_ = self.theta[0] self.coef_ = self.theta[1:] return self
def predict_proba(self, X): X_b = np.c_[np.ones((X.shape[0], 1)), X] return self.softmax(X_b @ self.theta)
def predict(self, X): return self.classes[np.argmax(self.predict_proba(X), axis=1)]直接计算 Softmax 时,需要计算 。
inf。# 不安全的实现 —— 会溢出!def bad_softmax(scores): exp_scores = np.exp(scores) # 如果 scores 包含 1000,这里就爆了 return exp_scores / exp_scores.sum()解决方案是利用一个恒等变换:
其中 。这个等式对任意 都成立。
取 为所有得分中的最大值后,,所以 ,绝对不会溢出。
对于 Log-Softmax(即 ,在计算交叉熵时常用):
代码实现:
def stable_softmax(scores): """数值稳定的 Softmax 实现""" m = np.max(scores, axis=-1, keepdims=True) safe_scores = scores - m exp_scores = np.exp(safe_scores) return exp_scores / np.sum(exp_scores, axis=-1, keepdims=True)
def stable_log_softmax(scores): """数值稳定的 Log-Softmax 实现""" m = np.max(scores, axis=-1, keepdims=True) safe_scores = scores - m log_sum_exp = m + np.log(np.sum(np.exp(safe_scores), axis=-1, keepdims=True)) return safe_scores - log_sum_exp
# 测试scores = np.array([1000, 1001, 1002])print("Stable softmax:", stable_softmax(scores))print("Stable log_softmax:", stable_log_softmax(scores))# 输出: 概率分布合理,不会溢出在实际的深度学习框架(PyTorch、TensorFlow)中,永远不要单独计算 Softmax 再取 Log,而是直接使用 log_softmax 或 CrossEntropyLoss。CrossEntropyLoss 内部已经集成了 LogSoftmax + NLLLoss,数值稳定且高效。
在二分类中,我们有 TP、FP、TN、FN。在多分类中,每个类别都有自己的 TP、FP、FN:
每个类别的 Precision 和 Recall 为:
每个类别的 F1-Score 为:
宏平均对每个类别平等对待,先计算每个类别的指标,再取算术平均:
特点:每个类别权重相同,不受类别不平衡影响;少数类的表现会被同等重视;适合每个类别都很重要的场景
微平均先汇总所有类别的 TP、FP、FN,再统一计算:
注意:在多分类单标签问题中,微平均 F1 等于准确率(Accuracy) 。
特点:每个样本被平等对待,大类别主导指标;对类别不平衡不敏感(实际上是被大类主导了);适合整体准确性比每个类别的公平性更重要的场景
from sklearn.metrics import confusion_matrix, f1_scoreimport numpy as np
def macro_f1(y_true, y_pred, num_classes): """手动计算宏平均 F1""" cm = confusion_matrix(y_true, y_pred, labels=range(num_classes)) f1s = [] for k in range(num_classes): TP = cm[k, k] FP = cm[:, k].sum() - TP FN = cm[k, :].sum() - TP precision = TP / (TP + FP) if (TP + FP) > 0 else 0 recall = TP / (TP + FN) if (TP + FN) > 0 else 0 f1 = 2 * precision * recall / (precision + recall) if (precision + recall) > 0 else 0 f1s.append(f1) return np.mean(f1s)
def micro_f1(y_true, y_pred, num_classes): """手动计算微平均 F1""" cm = confusion_matrix(y_true, y_pred, labels=range(num_classes)) total_TP = np.trace(cm) total_FP = cm.sum() - total_TP # 在多分类中,总FP = 总FN total_FN = cm.sum() - total_TP precision = total_TP / (total_TP + total_FP) if (total_TP + total_FP) > 0 else 0 recall = total_TP / (total_TP + total_FN) if (total_TP + total_FN) > 0 else 0 return 2 * precision * recall / (precision + recall) if (precision + recall) > 0 else 0
# 示例y_true = np.array([0, 0, 1, 1, 2, 2, 2])y_pred = np.array([0, 1, 1, 2, 2, 0, 1])
print(f"Macro F1 (手动): {macro_f1(y_true, y_pred, 3):.4f}")print(f"Micro F1 (手动): {micro_f1(y_true, y_pred, 3):.4f}")print(f"Macro F1 (sklearn): {f1_score(y_true, y_pred, average='macro'):.4f}")print(f"Micro F1 (sklearn): {f1_score(y_true, y_pred, average='micro'):.4f}")| 场景 | 推荐指标 | 原因 |
|---|---|---|
| 类别均衡 | Macro 或 Micro 差别不大 | 两者结果相近 |
| 类别严重不平衡,关心少数类 | Macro | 平等对待每个类别 |
| 类别严重不平衡,关心整体表现 | Micro | 受多数类主导,反映整体准确性 |
总结
概念 二分类(逻辑回归) 多分类(Softmax 回归) 激活函数 Sigmoid: Softmax: 输出 1 个概率(正类) K 个概率(和为 1) 损失函数 二分类交叉熵 多分类交叉熵 参数数量 梯度形式 核心要点回顾
- Sigmoid 函数将线性输出映射到 (0, 1) 区间,其导数 形式简洁,是梯度下降高效计算的关键。
- 对数几率(Log Odds) 揭示了逻辑回归的本质:用线性模型 去逼近真实标签的对数几率。决策边界 是线性的。
- 最大似然估计推导出交叉熵损失函数,梯度形式与线性回归相似,区别仅在于预测函数从 变成了 。
- Softmax 回归是逻辑回归在多分类(类别互斥)场景下的自然推广,使用 Log-Sum-Exp Trick 保证数值稳定性——永远不要单独计算 Softmax 再取 Log。
- 宏平均(Macro) 平等对待每个类别,适合不平衡数据;微平均(Micro) 平等对待每个样本,适合关注整体准确性的场景。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章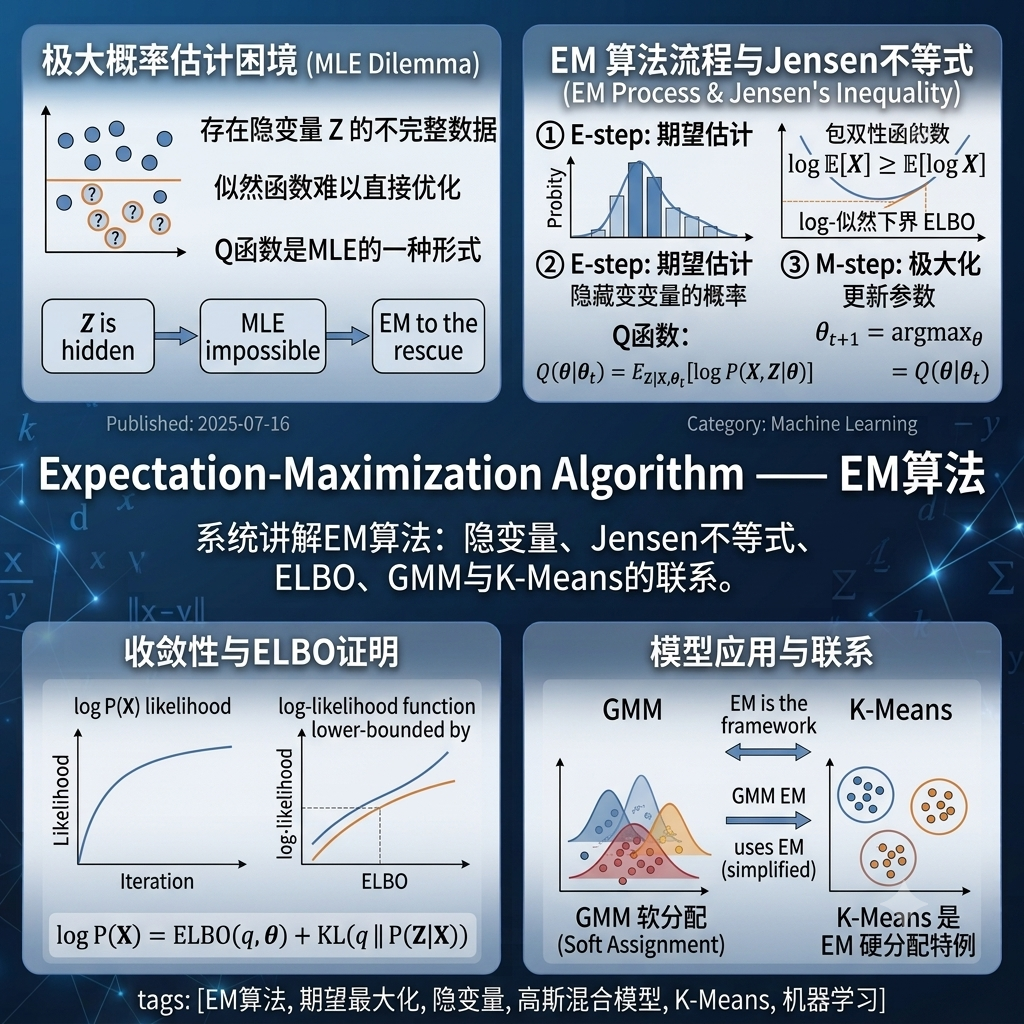
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章
系统讲解K-Means聚类的核心原理与算法细节,涵盖Lloyd交替优化算法的收敛性分析、K-Means作为EM算法特例的理论联系(硬分配 vs 软分配)、K-Means++初始化策略的D²采样机制与O(log K)近似保证,以及肘部法则与轮廓系数的选择K值方法及其局限。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面