


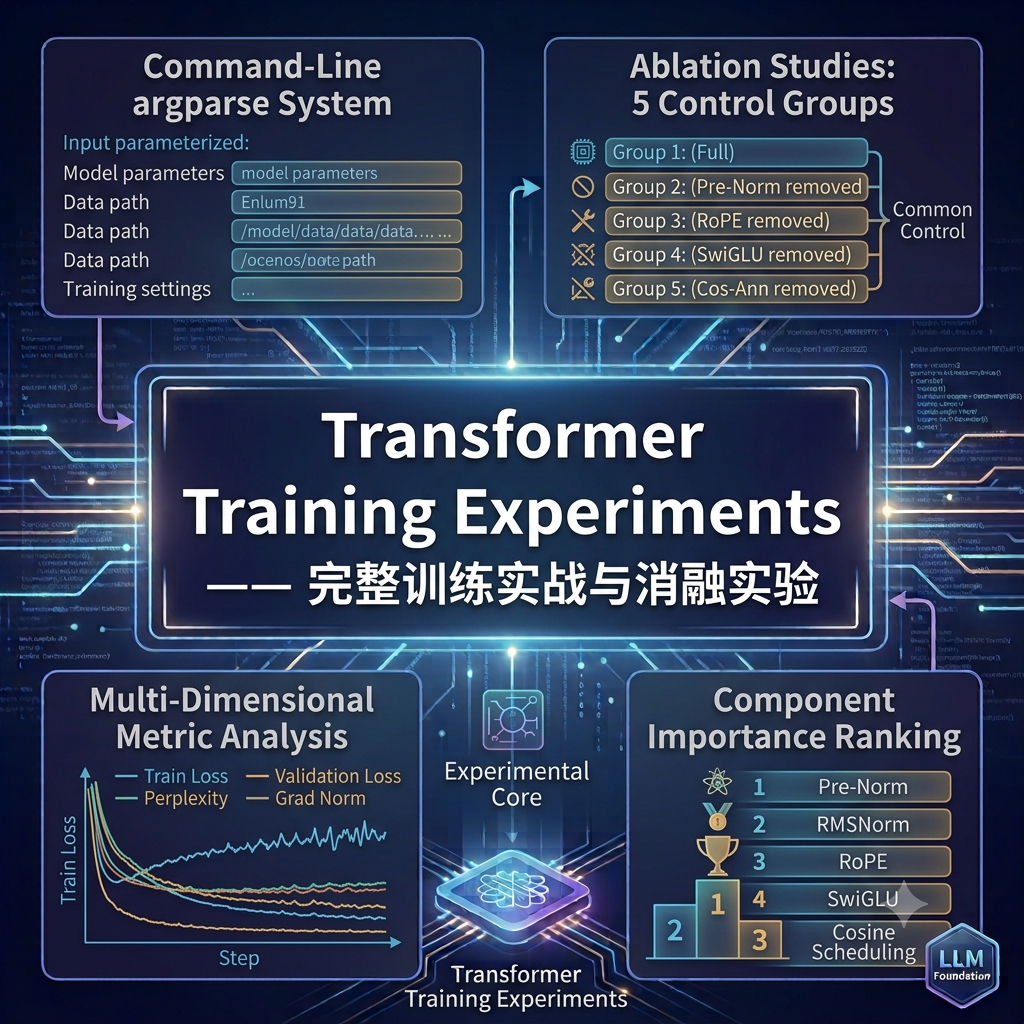
Transformer Training Experiments —— 完整训练实战与消融实验
系统讲解基于argparse的命令行训练脚本设计与五组消融实验的科学验证:从高度参数化的训练框架出发,设计五组对照实验以量化各组件贡献;基于训练损失/验证损失/困惑度/梯度范数等多维度指标分析,得出各组件重要性排序;展示完整的训练循环实现及自动化批量实验的工程价值。附有完整命令行参数体系与实验配置。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
在第一篇博客中,我们完成了大语言模型的“第一公里”——从零构建了一个完整的BPE分词器,能够将原始文本转化为token ID序列。现在,我们要进入模型的“施工阶段”:如何将这些token ID变成真正的智能?
这篇博客的目标是搭建Transformer的基石——构成大模型的全部基础算子模块。我们将逐一实现:
所有这些模块都不依赖PyTorch的高层封装(如torch.nn.Linear),而是从PyTorch 最基础的张量操作和nn.Parameter 开始构建。这不仅是为了满足项目的技术约束,更重要的是让每个参数的意义变得透明。
在PyTorch中,torch.nn.Linear是最常用的模块之一。它封装了权重矩阵和偏置的创建、初始化、前向传播。但在本项目中,我们需要从零构建所有模块——这意味着只能使用PyTorch的 nn.Parameter和基本张量操作,而不直接使用nn.Linear。
深入理解线性层的内部结构,是理解所有深度学习模型参数规模计算、梯度流、初始化策略的基础。当看到Transformer中有数十亿参数时,需要清楚地知道:每一个参数来自哪里、形状是什么、在训练中如何变化。
线性层的数学公式极其简洁:
其中:
d_in)d_out × d_in)d_out)如果省略偏置(代码中的实现),则简化为:
从信息流的角度看,线性层做的事情是:将输入的每个特征,通过加权求和的方式,映射到输出空间的每个维度。 控制了输入特征 对输出特征 的贡献强度。
在PyTorch标准实现中,线性层的权重形状为 (out_features, in_features):
weight_shape = (out_features, in_features)self.weight = nn.Parameter(torch.empty(weight_shape, device=device, dtype=dtype))这意味着在矩阵乘法中,输入x的形状是 (..., d_in),权重W的形状是 (d_out, d_in),输出为 (..., d_out)。
前向传播时,采用einsum表示这个操作:
def forward(self, x: torch.Tensor) -> torch.Tensor: return einsum(x, self.weight, '... d_in, d_out d_in -> ... d_out')einsum(爱因斯坦求和约定)的写法清晰地表达了:输入在最后一维d_in与权重的第二维d_in进行点乘,结果输出到d_out维度。
模型参数的初始化方式对训练的稳定性有决定性影响。代码中使用了截断正态分布(Truncated Normal),并采用了特定于“mishmash”架构的初始化策略:
sigma = math.sqrt(2.0 / (in_features + out_features))torch.nn.init.trunc_normal_(self.weight, mean=0.0, std=sigma, a=-3 * sigma, b=3 * sigma)[-3σ, 3σ] 范围内,有效控制了这种风险。sqrt(2/(d_in + d_out))的原因:这是针对“mishmash”架构设计的初始化策略。对于标准线性层,常见的是Xavier初始化(1/sqrt(d_in)或sqrt(2/(d_in + d_out))),这里使用的是后者的一种变体。核心思想是保持输入和输出的方差一致,从而避免梯度消失或爆炸。线性层是Transformer中最密集的参数来源。以GPT-2 124M为例,其线性层参数占总参数的95%以上。理解线性层的参数规模计算方法如下:
d_in × d_out 的权重矩阵有 d_in × d_out 个参数d_model × d_model 参数d_model × d_ff + d_ff × d_model 参数词嵌入(Word Embedding) 做的事情很简单:将离散的token ID映射为稠密的连续向量。在代码层面,嵌入层本质上是一个查找表:
def forward(self, token_ids: torch.Tensor) -> torch.Tensor: return self.embedding_matrix[token_ids]给定一个形状为 (batch_size, seq_len) 的token ID张量,返回形状为 (batch_size, seq_len, embedding_dim) 的向量张量。
嵌入矩阵的形状为 (num_embeddings, embedding_dim):
embedding_shape = (num_embeddings, embedding_dim)self.embedding_matrix = nn.Parameter(torch.empty(embedding_shape, device=device, dtype=dtype))num_embeddings = 词汇表大小(vocab_size),即有多少种不同的tokenembedding_dim = 嵌入向量的维度,也就是Transformer中的 d_model比如第一篇博客训练的BPE分词器有18,017个token,如果 d_model=768,嵌入矩阵就是 (18017, 768),约1,380万参数。
代码中用标准差为1的截断正态分布初始化嵌入矩阵:
std = 1.0torch.nn.init.trunc_normal_(self.embedding_matrix, std=std, a=-3 * std, b=3 * std)这是一个相对温和的初始化——标准差为1,截断在±3范围内。在实际训练中,嵌入层通常配合学习率调度器使用(通常使用稍高的学习率),因为嵌入层需要快速适应训练数据中的token分布。
从数学角度看,嵌入层是线性层的特例:当输入是独热(one-hot)向量时,线性变换 one_hot × Embedding_Matrix 就是查表操作。但直接使用独热向量在计算上不可行(词汇表高达数万),所以PyTorch用查表作为高效的替代方案。
两者在梯度流上的表现相同:在反向传播中,token ID对应的那一行嵌入向量会接收到梯度,其他行不变。
深度神经网络在训练中会遇到一个棘手的问题:内部协变量偏移(Internal Covariate Shift) —— 网络各层输入的分布会随着前面层参数的变化而变化,导致训练不稳定,收敛缓慢。
归一化层的作用就是将每层的输入拉回到一个稳定的分布范围,从而让梯度流动更加平稳。在Transformer中,归一化层通常放在残差连接之后、每个子层之前(Pre-Norm结构)。
Layer Normalization(LayerNorm) 的公式为:
其中 和 分别是均值和方差, 和 是可学习的缩放和偏移参数。
RMSNorm 的公式为:
其中 。
核心区别在于:
RMSNorm在LLM领域的流行始于Llama系列模型。其优势在于:
def forward(self, x: torch.Tensor) -> torch.Tensor: input_dtype = x.dtype x = x.to(torch.float32) # 先转为float32,避免数值不稳定
variance = x.pow(2).mean(-1, keepdim=True) x = x * torch.rsqrt(variance + self.eps)
return (self.weight * x).to(input_dtype)关键细节:计算归一化时先将输入转换为float32。这是因为在混合精度训练(如bfloat16或float16)中,中间计算可能产生下溢或溢出。rsqrt(倒数平方根)在低精度下对极大值或极小值特别敏感,所以先在float32下计算,再转回原始精度。
Transformer的原始设计中,前馈网络(FFN)是一个简单的两层线性网络加ReLU激活:
这个结构简单有效,但存在一个问题:ReLU在负半区输出恒为零,导致“神经元死亡”现象——部分神经元在训练中可能永远不被激活。
SwiGLU(Swish-Gated Linear Unit)是近年来LLM架构中最重要的改进之一,被Llama、Mistral、PaLM等模型广泛采用。
SwiGLU的公式为:
其中 , 是sigmoid函数, 是逐元素相乘。
这个结构包含三个权重矩阵:、、。这里的 和 并行作用在输入上, 的输出经过Swish激活后与 的输出逐元素相乘,再通过 映射回 d_model。
为了公平比较,在参数量相当的前提下对比两种设计:
d_ff,参数量为 d_model × d_ff + d_ff × d_model = 2 × d_model × d_ff3 × d_model × d_ff(、、各一个)如果希望SwiGLU的参数量与经典FFN持平,需要将 d_ff 缩小为 2/3。在FFN中通常取 d_ff = 4 × d_model,因此在SwiGLU中通常取 d_ff = 8/3 × d_model,确保能被64整除。
代码中提供了一个可选开关:
class SwiGLU(nn.Module): def __init__(self, d_model, d_ff, use_swiglu=True): self.w1 = LinearModule(d_model, d_ff) self.w2 = LinearModule(d_ff, d_model) if use_swiglu: self.w3 = LinearModule(d_model, d_ff)当 use_swiglu=True 时, 被创建,前向传播变为:
return self.w2(self.silu(self.w1(x)) * self.w3(x))当 use_swiglu=False 时,回退为标准的 FFNSiLU(即用SiLU替代ReLU):
return self.w2(self.silu(self.w1(x)))SwiGLU的核心优势在于门控机制(Gating)。 经过Swish激活后充当“门”, 充当“值”,门控选择性地让哪些信息通过。这类似于LSTM中的“输入门”设计。
这种结构赋予了FFN更强的非线性表达能力。在LLM的scaling law实验中,SwiGLU被证明能在大约相同参数量下实现比ReLU-FFN更低的困惑度,这也是当今几乎所有前沿开源LLM都采用SwiGLU的原因。
Transformer的自注意力机制本身是置换不变(Permutation Invariant)的 —— 把“我 爱 你”三个词打乱顺序,得到的注意力计算结果和原顺序是一样的。这显然不符合语言的基本特性:顺序决定意义。
因此,模型需要一种方式来注入位置信息。传统的位置编码方案包括:
RoPE(Rotary Positional Embedding) 由苏剑林提出,是目前最主流的位置编码方案,被Llama、PaLM、Qwen等模型采用。
RoPE的核心思想是 —— 不额外添加位置向量,而是通过旋转矩阵“转动”词向量,使得词向量的方向携带了位置信息。
1. 从二维平面看本质
在二维平面上,将向量旋转角度 的矩阵为:
对于第 个位置的token,其查询向量 被旋转角度 :,键向量同理 。
2. 核心性质推导(相对距离的自动生成)
RoPE编码相对位置的关键在于旋转矩阵具有正交同态性质:。
计算旋转后查询和键的注意力分数(点积):
由于转置性质 ,且旋转矩阵满足 ,代入得:
最终结果中,旋转角度直接变成了 。也就是说,注意力分数只依赖于两个token之间的相对距离 ,与它们各自的绝对位置 、 无关。这就把绝对位置编码巧妙地转化成了相对位置编码。
3. 扩展到高维空间(复数视角)
现实中的词向量维度 远大于2。RoPE的处理方式是将 维空间划分为 个二维子空间,每个子空间使用不同的旋转频率 。
从复数视角看,这相当于把每对维度 视为一个复数 ,旋转操作即是乘以单位复数 :
两个维度组成一个二维子空间,构成一个“复数对”。如果 是奇数,最后一维无法配对成复数,就无法进行旋转操作。最终,整个高维旋转矩阵 是一个分块对角矩阵(Block Diagonal Matrix):
\text{Rot}(m\theta_0) & 0 & \cdots & 0 \\ 0 & \text{Rot}(m\theta_1) & \cdots & 0 \\ \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & \cdots & \text{Rot}(m\theta_{d_k/2-1}) \end{bmatrix}$$ **不同的 $\theta_i$ 让不同维度的向量以不同的“速度”旋转,从而可以区分长距离和短距离的相对位置依赖。** ### 5.3 theta参数的作用 在代码中,`theta` 是一个关键超参数: ```python freqs = 1.0 / (self.theta ** (torch.arange(0, self.d_k, 2).float() / self.d_k)) ``` 对于维度 $d_k$ 的向量,我们将每两个维度(如第0和第1维、第2和第3维)作为一组,应用**不同频率的旋转**。第 $i$ 组的旋转角度为: $$\theta_i = \text{theta}^{-2i/d_k}$$ **`theta` 控制着旋转频率的衰减速度**。较小的 `theta`(如1000)会使高频旋转衰减更快,模型对近期位置更敏感;较大的 `theta`(如10000)则使**旋转频率分布更平缓**。 在实践中,`theta=10000` 是Llama系列采用的默认值。这个值在原始Transformer的**正弦位置编码**中也被使用——它确保最低频的旋转周期约为10000个位置,足以覆盖模型的**最大序列长度**。 ### 5.4 配对旋转的实现 在实现中,代码通过 `view` 将最后一维重组为 `(d_k // 2, 2)`,再进行**配对旋转**: ```python x = x.view(batch_size, seq_len, d_model // 2, 2) rotated = torch.stack([ x[..., 0] * cos - x[..., 1] * sin, x[..., 0] * sin + x[..., 1] * cos ], dim=-1) return rotated.flatten(-2) ``` **1. 代码中 `view` 重组的深层思想** - 代码中 `x.view(batch_size, seq_len, d_k // 2, 2)` 的本质,是**改变张量的“语义视图”**。 - 它把最后一维(特征维)重新解释为两个轴:**最后一维长度变为 2(实部、虚部,或偶数索引、奇数索引);之前的维度变为 $d_k // 2$(复数个数)**。 - 这样一来,原本线性排列的向量 `[x0, x1, x2, x3, ...]` 就被重组为了复数对序列 `[(x0, x1), (x2, x3), ...]`。 **2. 配对旋转的数学运算** 在重组为 `(..., 2)` 后,对最后一维执行标准的2D旋转公式。 假设 `x[..., 0]` 是实部(偶数维),`x[..., 1]` 是虚部(奇数维),旋转角度为 $\theta$: $$\text{实部}' = \text{实部} \times \cos\theta - \text{虚部} \times \sin\theta$$ $$\text{虚部}' = \text{实部} \times \sin\theta + \text{虚部} \times \cos\theta$$ 代码中的 `torch.stack` 正是将这两个计算结果**重新堆叠为最后一维长度为2的新复数对**: ```python rotated = torch.stack([ x[..., 0] * cos - x[..., 1] * sin, # 新实部 x[..., 0] * sin + x[..., 1] * cos # 新虚部 ], dim=-1) # 此时形状为 (batch, seq, d_k//2, 2) ``` 最后通过 `rotated.flatten(-2)`,**将 `(d_k // 2, 2)` 压缩回原来的单一维度 `d_k`**,完成**旋转位置编码**的注入。 **关键点**:用 `view` 而不是 `reshape`的原因 —— 虽然两者功能相似,但 `view` 要求张量在内存中**连续(contiguous)**。RoPE的输入通常是经过**线性投影($W_q, W_k$)后的结果**,默认是连续的,因此使用 `view` 开销更小(仅改变元数据,**不复制数据**),**效率更高**。 ### 5.5 RoPE的工程实现要点 1. **预计算sin/cos表格**:在`__init__`中**预先为所有位置计算好正弦和余弦值**,存储为`buffer`。这避免了在前向传播中反复计算三角函数,提高效率。 2. **位置索引**:`token_positions`参数是一个整数张量,记录了**每个token在序列中的绝对位置**(从0开始)。模型通过**索引查表**得到对应的sin/cos值。 3. **二维配对旋转**:每**两个维度**组成一个复数进行旋转。 RoPE的本质为位置信息提供了一种**几何解释**——**词向量在高维空间中的旋转角度编码了位置,而旋转的“速度”由theta参数控制**。这比传统位置编码更优雅,也更高效。 --- ## 六、模块间的依赖关系 我们现在已经完成了全部基础模块的实现。下图展示了这些模块如何组织成更大的结构: ``` BPE分词器 (第一篇) ↓ Token IDs (整数序列) ↓ ┌─────────────────────────────────────────────────┐ │ EmbeddingModule │ │ └── token_id → 稠密向量 (d_model维) │ └─────────────────────────────────────────────────┘ ↓ ┌─────────────────────────────────────────────────┐ │ RoPE (对位置进行编码) │ │ └── 在注意力计算前,将位置信息注入Q和K │ └─────────────────────────────────────────────────┘ ↓ ┌─────────────────────────────────────────────────┐ │ Multi-Head Attention (后续博客实现) │ │ └── 使用 LinearModule 构建 Q/K/V/O 投影 │ │ └── 使用 RoPE 对 Q/K 施加旋转位置编码 │ └─────────────────────────────────────────────────┘ ↓ ┌─────────────────────────────────────────────────┐ │ RMSNorm (Pre-Norm) │ │ └── 稳定训练,放在每个子层之前 │ └─────────────────────────────────────────────────┘ ↓ ┌─────────────────────────────────────────────────┐ │ SwiGLU FFN │ │ └── 使用 LinearModule 构建 W1/W2/W3 │ │ └── 非线性激活,增强表达能力 │ └─────────────────────────────────────────────────┘ ``` 值得注意的是,这些模块的使用方式遵循了现代Transformer的设计范式: - **Pre-Norm**:**RMSNorm放在残差连接之前**(即子层之前),而不是之后。这被证明训练更稳定。 - **并行化**:SwiGLU中的$W_1$和$W_3$可以**并行计算**,在GPU上效率很高。 - **RoPE的集成**:RoPE不是独立的“层”,而是**在注意力计算中直接修改Q和K向量 —— 先计算Q/K投影,再施加RoPE旋转,再计算注意力分数**。 > [!note] 总结 > 本文完成Transformer架构中全部基础模块的从零实现: > 1. **LinearModule**:展示了线性变换的本质是矩阵乘法,以及参数初始化的重要性 > 2. **EmbeddingModule**:揭示了词嵌入层本质上是一个查找表,将离散ID映射到连续空间 > 3. **RMSNorm**:解释了为什么现代LLM偏爱RMSNorm——少减一次均值,多一分效率 > 4. **SwiGLU**:用三矩阵结构引入了门控机制,让FFN具备更强的非线性表达能力 > 5. **RoPE**:通过旋转矩阵优雅地注入位置信息,同时在注意力中自然地编码了相对位置 > > 这些模块共同构成了Transformer的“承重墙”——它们不直接产生智能,但没有它们,智能无从谈起。按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解基于argparse的命令行训练脚本设计与五组消融实验的科学验证:从高度参数化的训练框架出发,设计五组对照实验以量化各组件贡献;基于训练损失/验证损失/困惑度/梯度范数等多维度指标分析,得出各组件重要性排序;展示完整的训练循环实现及自动化批量实验的工程价值。附有完整命令行参数体系与实验配置。
阅读文章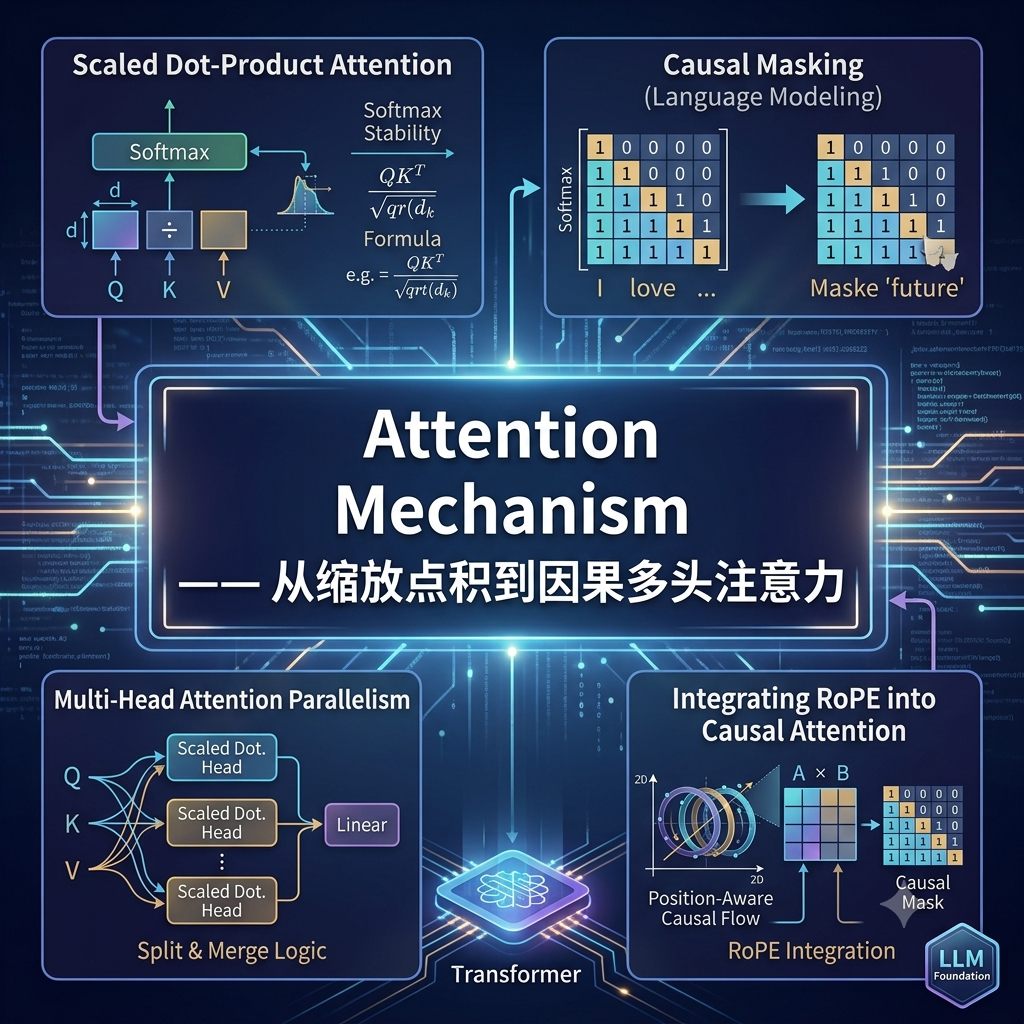
系统讲解Transformer注意力机制的核心原理与完整实现:从数值稳定的Softmax出发,推导缩放点积注意力的数学公式与几何意义;深入剖析因果掩码的下三角矩阵机制及其在自回归语言模型中的关键作用;详解多头注意力的拆分与合并逻辑及并行计算优势;最后阐述RoPE旋转位置编码如何直接融入注意力计算,与因果掩码协同实现带位置感知的因果注意力。
阅读文章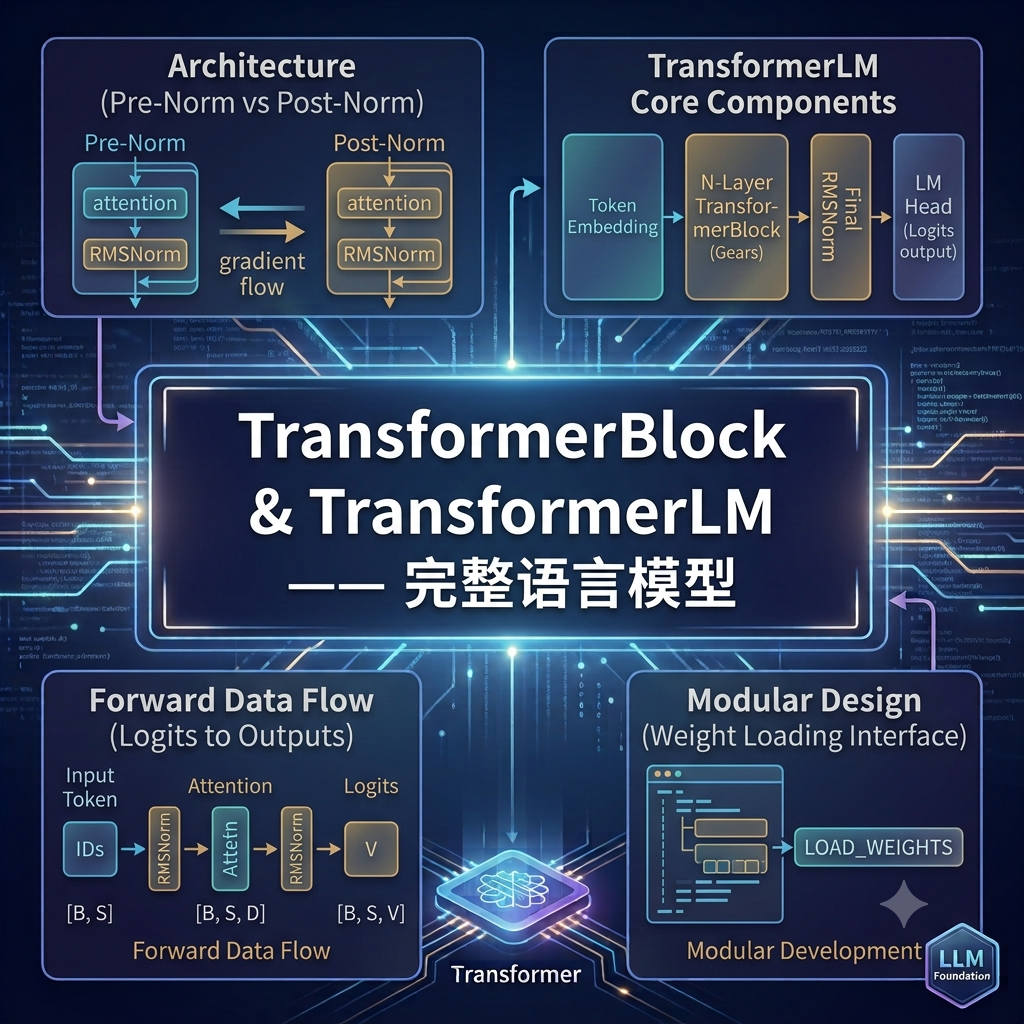
系统讲解如何将Transformer的各个组件组合成完整的可训练语言模型:从TransformerBlock的Pre-Norm与Post-Norm架构对比入手,剖析残差连接如何保障深层网络梯度流动;深入模块化设计中的权重加载接口;拆解TransformerLM四大核心组件(Token Embedding → N层TransformerBlock → Final RMSNorm → LM Head)及其超参数设计的权衡考量;完整跟踪从token ID到logits的前向传播数据流(形状变换全程)。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面