



Kernel Trick —— 核技巧与常用核函数
系统讲解核方法的数学原理与常用核函数的映射本质。涵盖核函数的定义、Mercer定理作为核方法的理论基石、核技巧将线性SVM对偶问题中的内积替换为核函数从而优雅处理非线性问题、多项式核的有限维映射与RBF(高斯)核的无穷维映射,以及RBF核中gamma参数对过拟合与欠拟合的影响与调优策略。
阅读文章
ZHY's Blog
A UNIVERSE OF IDEAS · BY ZHANG HAOYI
让好奇心 点亮知识宇宙
在代码、模型与思想之间自由漫游。这里持续记录人工智能、机器学习、软件工程与成长实践,让每次阅读都成为一次新的发现。


ARTICLE NOTE
前四篇文章已为监督学习搭建了完整的坐标系:线性回归与逻辑回归构成了参数化模型的基石(前者回归、后者分类),KNN 引入了非参数化的距离度量视角,朴素贝叶斯则展示了生成式概率建模的独特路径。至此,分类器的工具箱中尚缺一位以几何直观见长的成员——支持向量机(SVM) 恰好填补了这个位置,它与逻辑回归并列为判别式模型的两大支柱,却在方法论上走向了截然不同的方向。
SVM 的核心思想极其干净:最大化分类超平面与最近样本点之间的几何间隔。这个“间隔最大化”的直觉,最终被凝练为一个凸二次规划问题 —— 理论优雅,全局最优解有保障。而 SVM 真正的美学魅力在于其推导链条的环环相扣:从函数间隔到几何间隔的尺度归一化,从硬间隔原始问题到拉格朗日对偶问题的等价转化,以及 KKT 条件中互补松弛性所揭示的稀疏性 —— 最终只有位于间隔边界上的支持向量决定模型,远离边界的样本对决策毫无贡献。
现实数据极少完美线性可分,因此本文将从软间隔 SVM 出发,引入松弛变量 与惩罚参数 ,并揭示其与 Hinge Loss 的等价性 —— 这一损失函数的形式恰好解释了 SVM 与逻辑回归在离群点鲁棒性上的本质差异:Hinge Loss 对已满足间隔约束的样本“漠不关心”,而 Log Loss 则持续受所有样本影响。
Note读完本文,你将理解 SVM 为何被誉为“传统机器学习时代最具理论深度的算法”。
而本文对偶形式中出现的样本内积 ,正是通往下一主题——核技巧(Kernel Trick) ——的关键入口:它允许我们将线性 SVM 无缝推广为非线性分类器,完成第一阶段从线性到非线性的最后一块拼图。
在二分类问题中,我们有一组训练样本 ,其中 ,。
我们希望找到一个超平面 将两类样本分开。对于任意样本点 ,分类决策为:
函数间隔的定义为:
其含义是:
但函数间隔有一个严重的问题:如果同时将 和 放大 N 倍,超平面本身完全不变,但函数间隔也会放大 N 倍因此,函数间隔不适合直接作为优化目标。
几何间隔定义为样本点到超平面的真实距离:
几何间隔就是点到超平面的距离。它的绝对值与点到直线的距离公式完全一致。
函数间隔与几何间隔的关系关键区别:几何间隔对 和 的缩放是不变的——同时放大 和 ,几何间隔保持不变。
对于一个包含 个点的数据集,分类的确信度与间隔大小正相关。我们希望找到的超平面,不仅要能正确分类,还要让所有样本点都尽可能远离超平面。这样,当新样本到来时,即使有轻微的扰动,也不容易被误分类。
因此,SVM 的目标是最大化最小几何间隔:
其中 ,即所有样本点中最小的几何间隔。
令 ,上述优化目标可改写为:
由于我们可以通过成比例地缩放 和 来任意调节 ,不妨令 。于是优化问题变为:
最大化 等价于最小化 ,进一步等价于最小化 (平方和 1/2 是为了后续求导方便)。
于是得到硬间隔SVM的原始问题(Primal Problem):
使约束条件取等号的样本点,即 的点,被称为支持向量。
两个异类支持向量到超平面的距离之和为:
最大化间隔 等价于最小化 ,这与上述优化目标一致。
直接求解原始问题虽然可行,但转化为对偶问题有三个重要优势:
对于原始问题,引入拉格朗日乘子 (),构造拉格朗日函数:
展开为:
拉格朗日对偶问题为:
第一步:对 和 求极小
令 对 和 的偏导为零:
将这两个结果代回拉格朗日函数:
第二步:对 求极大
得到对偶问题(Dual Problem) :
对于SVM这个凸优化问题,KKT条件是原始问题与对偶问题取得最优解的充分必要条件。
KKT条件包含以下四个部分:
(1)原始可行性(Primal Feasibility) :
(2)对偶可行性(Dual Feasibility) :
(3)互补松弛性(Complementary Slackness) :
这个条件极其重要!它意味着:
(4)梯度为零(Stationarity) :
求解对偶问题得到最优的 后,可以恢复原始参数:
对于 ,选择任意一个支持向量(),由互补松弛条件:
由于 ,两边同乘 :
在实际应用中,为了更鲁棒,通常取所有支持向量的平均值:
其中 是所有支持向量的下标集合。
代码实现:
import numpy as npfrom cvxopt import matrix, solvers
class HardMarginSVM: """硬间隔SVM(使用CVXOPT求解对偶问题)"""
def __init__(self): self.alpha = None self.w = None self.b = None self.support_vectors = None self.support_labels = None
def fit(self, X, y): n_samples, n_features = X.shape
# 构建对偶问题的二次规划形式 # 最大化: sum(alpha_i) - 0.5 * sum(alpha_i * alpha_j * y_i * y_j * x_i^T x_j) # 约束: sum(alpha_i * y_i) = 0, alpha_i >= 0
# P矩阵: P_ij = y_i * y_j * x_i^T x_j P = np.outer(y, y) * (X @ X.T) P = matrix(P.astype(np.float64))
# q向量: q_i = -1 (因为cvxopt求解的是最小化) q = matrix(-np.ones(n_samples).astype(np.float64))
# G矩阵和h向量: -alpha_i <= 0 => alpha_i >= 0 G = matrix(-np.eye(n_samples).astype(np.float64)) h = matrix(np.zeros(n_samples).astype(np.float64))
# A矩阵和b向量: sum(alpha_i * y_i) = 0 A = matrix(y.reshape(1, -1).astype(np.float64)) b = matrix(np.zeros(1).astype(np.float64))
# 求解QP sol = solvers.qp(P, q, G, h, A, b) self.alpha = np.array(sol['x']).flatten()
# 计算w self.w = np.sum(self.alpha[:, None] * y[:, None] * X, axis=0)
# 找出支持向量 (alpha > 1e-5) sv_idx = np.where(self.alpha > 1e-5)[0] self.support_vectors = X[sv_idx] self.support_labels = y[sv_idx]
# 计算b (取支持向量的平均值) self.b = np.mean([ self.support_labels[i] - self.w @ self.support_vectors[i] for i in range(len(self.support_vectors)) ]) return self
def predict(self, X): return np.sign(X @ self.w + self.b)硬间隔SVM要求所有样本都能被正确分类且满足 。这在现实数据中往往过于苛刻:
为了解决这个问题,软间隔SVM为每个样本引入一个松弛变量(Slack Variable) 。
约束条件被放松为:
松弛变量 的几何含义是样本点 到边界 的距离。
软间隔SVM的优化目标变为:
其中 是惩罚参数,控制着“最大化间隔”和“最小化分类错误”之间的权衡:
构造拉格朗日函数(引入 和 ):
对 、、 求偏导并令其为零:
由于 ,可得 。
代入后得到软间隔SVM的对偶问题:
与硬间隔的唯一区别是 的上限从 变成了 。
软间隔SVM可以等价地写成一个无约束优化问题:
其中 就是著名的 Hinge Loss(合页损失) 。
Hinge Loss 的数学定义为:
Hinge Loss 的特性:
松弛变量 与 Hinge Loss 的关系为:
因此,软间隔SVM的原始问题可以理解为L2正则化 + Hinge Loss。
代码实现:
def hinge_loss(y_true, y_pred): """Hinge Loss: max(0, 1 - y * y_pred)""" return np.maximum(0, 1 - y_true * y_pred)
# 示例y_true = np.array([1, -1, 1, -1])y_pred = np.array([0.8, -0.9, 1.5, 0.5])losses = hinge_loss(y_true, y_pred)print(f"Hinge Losses: {losses}")# 输出: [0.2, 0.1, 0. , 1.5]# 解释:# - 第1个样本: 1*0.8=0.8<1, 损失0.2# - 第2个样本: (-1)*(-0.9)=0.9<1, 损失0.1# - 第3个样本: 1*1.5=1.5>=1, 损失0# - 第4个样本: (-1)*0.5=-0.5<1, 损失1.5SVM和逻辑回归的核心差异在于损失函数不同:
| 模型 | 损失函数 | 数学形式 |
|---|---|---|
| 逻辑回归 | Log Loss(交叉熵) | |
| SVM | Hinge Loss |
其中 , 是 Sigmoid 函数。
Log Loss(逻辑回归)的特性:
Hinge Loss(SVM)的特性:
逻辑回归像一个完美主义者:每个样本都在尽力说服决策边界向自己这边移动。即使一个点已经离边界很远,它仍然在施加影响。一个极端的离群点会把决策边界向自己这边拉很远。
SVM像一个实用主义者:它只关心临界地带的样本。一旦一个样本离边界足够远(超过间隔),SVM就认为此样本已安全,不再需要考虑。因此,远离边界的离群点根本不影响SVM的决策边界。
SVM的鲁棒性可以通过参数 进一步调节:
from sklearn.svm import SVCfrom sklearn.linear_model import LogisticRegressionfrom sklearn.datasets import make_classificationimport matplotlib.pyplot as plt
# 生成包含离群点的数据np.random.seed(42)X, y = make_classification(n_samples=100, n_features=2, n_redundant=0, n_clusters_per_class=1, random_state=42)# 添加一个离群点X_outlier = np.array([[3.5, -2.5]])y_outlier = np.array([1])X_aug = np.vstack([X, X_outlier])y_aug = np.hstack([y, y_outlier])
# 训练逻辑回归和SVMlr = LogisticRegression(C=1.0)svm = SVC(kernel='linear', C=1.0)lr.fit(X_aug, y_aug)svm.fit(X_aug, y_aug)
# 打印系数差异print("逻辑回归系数:", lr.coef_)print("SVM系数:", svm.coef_)# 通常SVM的决策边界受离群点影响更小| 特性 | 逻辑回归 | SVM |
|---|---|---|
| 损失函数 | Log Loss(交叉熵) | Hinge Loss |
| 所有样本都有影响 | 是 | 否(只有支持向量有影响) |
| 对离群点敏感度 | 高 | 低 |
| 鲁棒性 | 较弱 | 较强 |
| 输出概率 | 天然输出概率 | 需要额外校准(Platt scaling) |
| 适用场景 | 需要概率解释、数据较干净 | 数据有噪声、需要强泛化能力 |
总结
概念 数学形式 核心作用 函数间隔 衡量分类确信度,但对缩放敏感 几何间隔 点到超平面的真实距离,缩放不变 硬间隔原始问题 ,s.t. 线性可分时的最大化间隔 硬间隔对偶问题 ,s.t. 更易求解,引入核函数 KKT条件 可行性 + 对偶可行性 + 互补松弛 + 梯度为零 原始与对偶最优解的充要条件 软间隔 ,s.t. 处理线性不可分数据 Hinge Loss SVM的损失函数,产生稀疏解 SVM vs LR Hinge Loss vs Log Loss SVM只关注支持向量,对离群点更鲁棒 核心要点回顾
- 函数间隔 vs 几何间隔:函数间隔对 和 的缩放敏感,而几何间隔是点到超平面的真实距离,是SVM优化的真正目标。
- 硬间隔SVM:要求所有样本满足 ,通过最大化间隔(等价于最小化 )找到最优超平面。
- 拉格朗日对偶:将原始问题转化为对偶问题,对偶形式中只出现样本内积 ,为核技巧铺平了道路。
- KKT条件:互补松弛条件 揭示了SVM的稀疏性——只有支持向量()影响模型。
- 软间隔与Hinge Loss:通过松弛变量 允许部分样本违反间隔约束,等价于在L2正则化上使用Hinge Loss。参数 控制着间隔宽度与分类误差的权衡。
- SVM vs 逻辑回归:SVM使用Hinge Loss,一旦样本满足间隔要求损失即为0,因此只有支持向量决定决策边界,对离群点更加鲁棒。逻辑回归使用Log Loss,所有样本都持续影响模型,对离群点更敏感。
按顺序完成这组文章,循序渐进地掌握主题
发现错误、内容过时或有改进想法?欢迎告诉我
根据本文分类与标签,为你推荐可能感兴趣的内容
系统讲解核方法的数学原理与常用核函数的映射本质。涵盖核函数的定义、Mercer定理作为核方法的理论基石、核技巧将线性SVM对偶问题中的内积替换为核函数从而优雅处理非线性问题、多项式核的有限维映射与RBF(高斯)核的无穷维映射,以及RBF核中gamma参数对过拟合与欠拟合的影响与调优策略。
阅读文章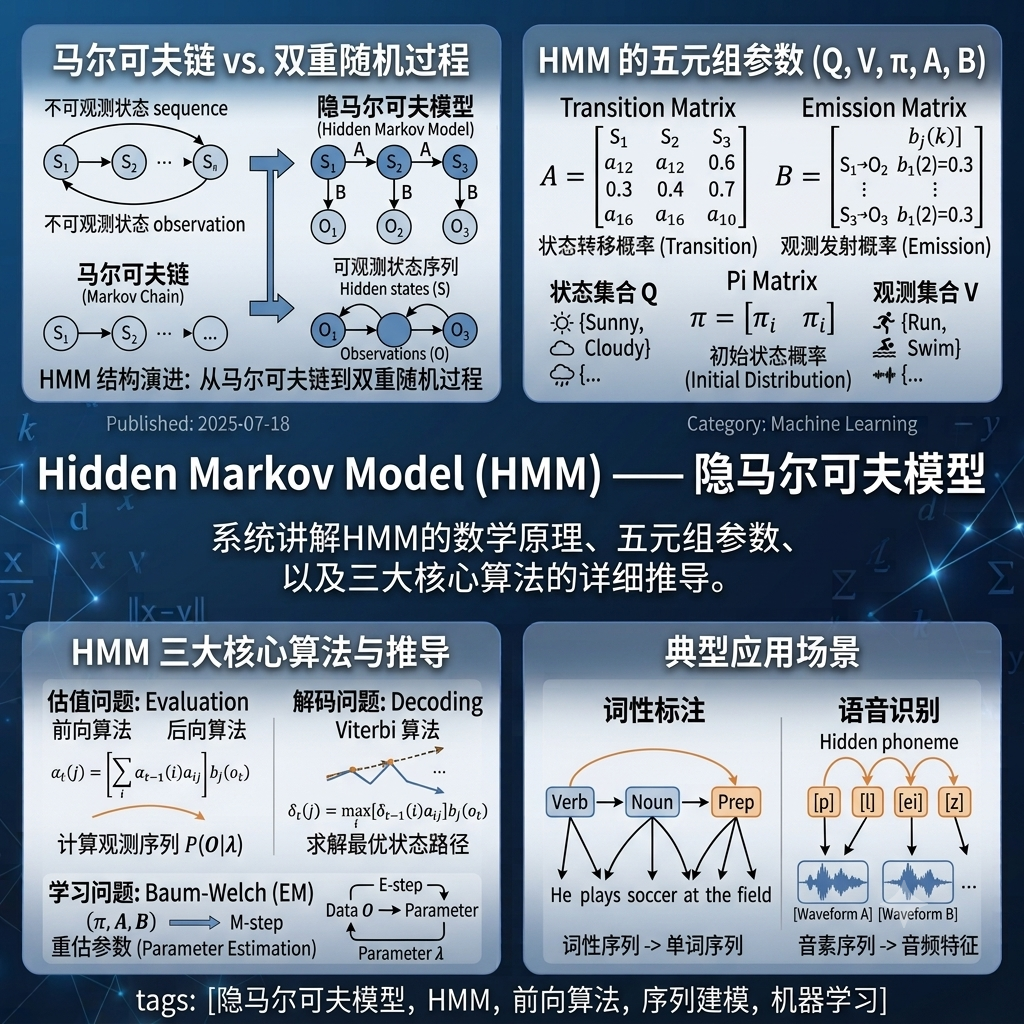
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
阅读文章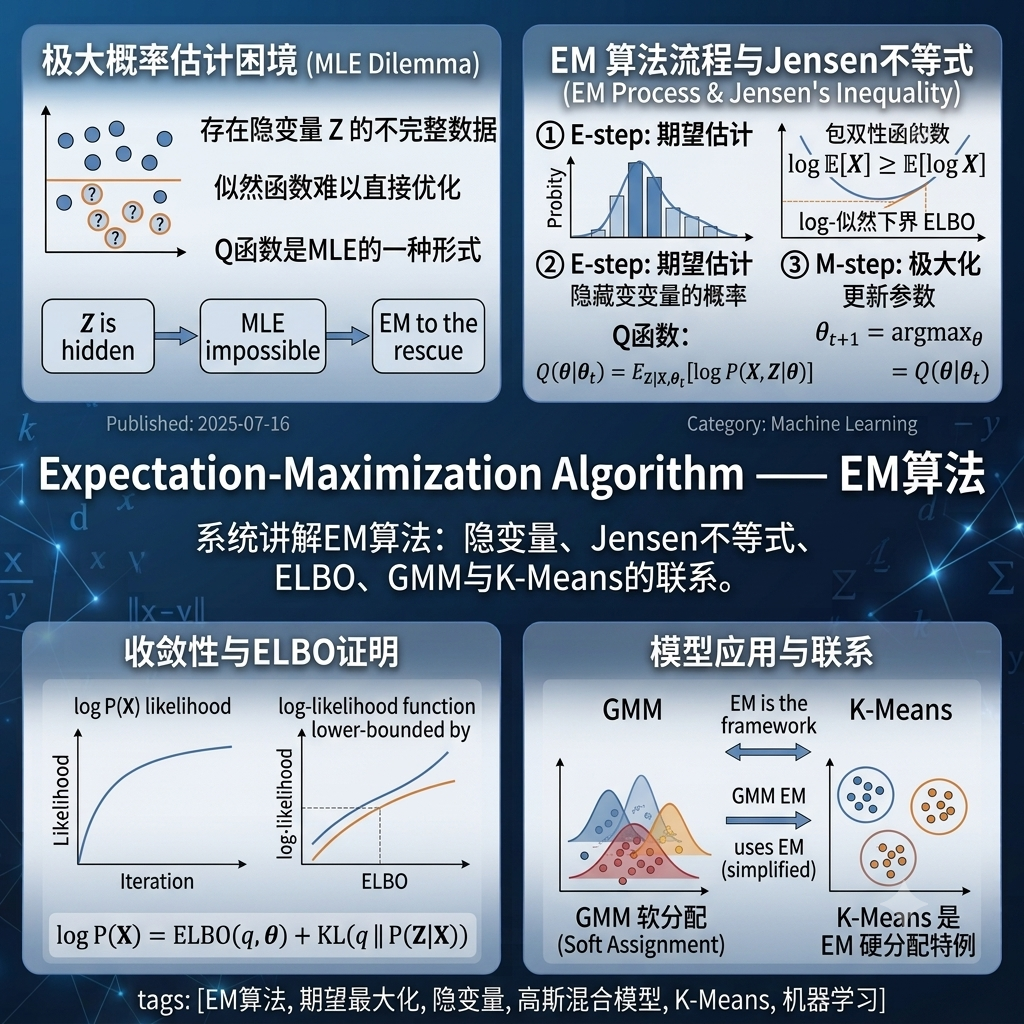
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
阅读文章请使用微信扫描二维码分享
当前文章会保持在原页面