





09
3 篇 KNOWLEDGE LIBRARY
文章
人工智能与软件开发系列文章
74篇文章
08
8 篇 2026年8月
Video Audio Multimodal —— 视频理解 & 视频生成 & 音频处理Vision-Language-Action —— VLA具身智能Multimodal RAG —— 多模态RAGDenoising Diffusion Probabilistic Models —— DDPM扩散模型Multimodal Large Language Model —— MLLM多模态大语言模型Vision-Language Model —— VLM视觉语言模型Vision Transformer —— ViT视觉TransformerContrastive Language-Image Pre-training —— CLIP对比学习
07
8 篇 2026年7月
RLVR (Reinforcement Learning with Verifiable Rewards) —— 可验证奖励强化学习Comparison of RL Algorithm —— PPO、GRPO、DPO、DAPO、GSPO技术详解与对比GSPO (Group Sequence Policy Optimization) -- 群组序列策略优化DAPO (Decoupled Clip and Dynamic sAmpling Policy Optimization) -- 解耦裁剪与动态采样策略优化GRPO (Group Relative Policy Optimization) -- 群体相对策略优化DPO (Direct Preference Optimization) -- 直接偏好优化PPO(Proximal Policy Optimization) -- 近端策略优化Reinforcement Learning -- 策略梯度、优势函数、重要性采样与KL散度惩罚
06
3 篇 2026年6月
04
8 篇 2026年4月
Multi-Agent System—— 多智能体系统Agent Communication Protocols —— MCP & A2AAgent Engineering —— Prompt & Context & Harness & LoopMemory System —— Agent记忆系统Retrieval-Augmented Generation —— 检索增强生成Function Calling —— 工具调用Agent Paradigms —— ReAct & Plan-and-Solve & ReflectionAgent Architecture —— LLM & Planning & Tool & Memory
03
7 篇 2026年3月
02
9 篇 2026年2月
08
10 篇 2025年8月
LSTM & GRU —— 门控循环神经网络RNN & BPTT —— 循环神经网络与随时间反向传播Residual Network —— ResNet残差网络CNN —— 卷积神经网络Gradient Descent Optimizer —— 梯度下降优化器MLP & Back Propagation —— 多层感知机与反向传播Autograd & Computational Graph —— 自动微分与计算图Activation & Initialization —— 激活函数与权重初始化Probability & Information —— 概率论与信息论基础Tensor Operations —— 向量、矩阵与张量运算
07
15 篇 2025年7月
Hidden Markov Model (HMM) —— 隐马尔可夫模型Expectation-Maximization Algorithm —— EM算法K-Means Clustering —— 聚类算法Principal Component Analysis (PCA) —— 主成分分析XGBoost & LightGBM —— 梯度提升框架Gradient Boosting Machine (GBM) —— 梯度提升机与加法模型Adaptive Boosting (AdaBoost) —— 自适应提升Bagging & Random Forest —— 随机森林Decision Tree —— 决策树Kernel Trick —— 核技巧与常用核函数Support Vector Machine (SVM) —— 支持向量机Naive Bayes —— 朴素贝叶斯K-Nearest Neighbor (KNN) —— K-近邻Logistic Regression —— 逻辑回归与Softmax多分类Linear Regression —— 线性回归
06
3 篇 2025年6月
按发布时间倒序排列
8 个主题 · 主题内按发布时间排序
CURRENT SIGNAL
最受关注的文章
01
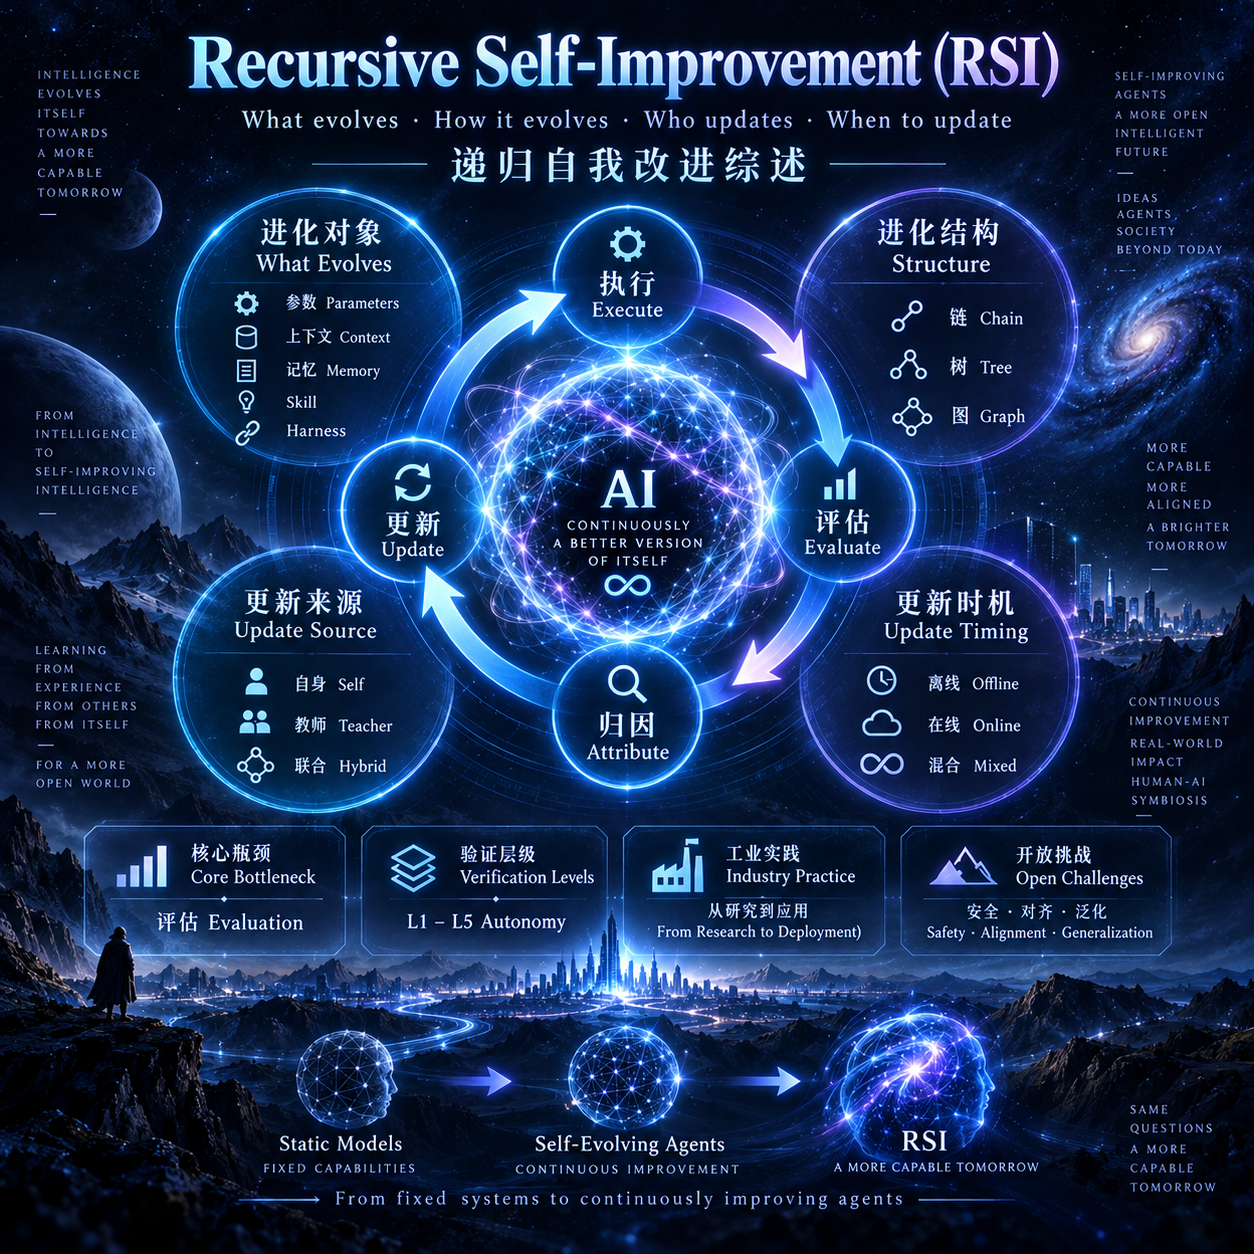
Recursive Self-Improvement(RSI)—— 递归自我改进综述
系统解读递归自我改进(RSI)综述,围绕进化对象(参数、上下文、记忆、Skill、Harness代码)、进化结构(链、树、图)、更新来源(自身、教师、联合)、更新时机(离线、在线、混合)等维度建立 RSI 分类体系,并深入分析评估瓶颈、验证层级、L1-L5 自主性谱系、工业实践与开放挑战。
—热度
02
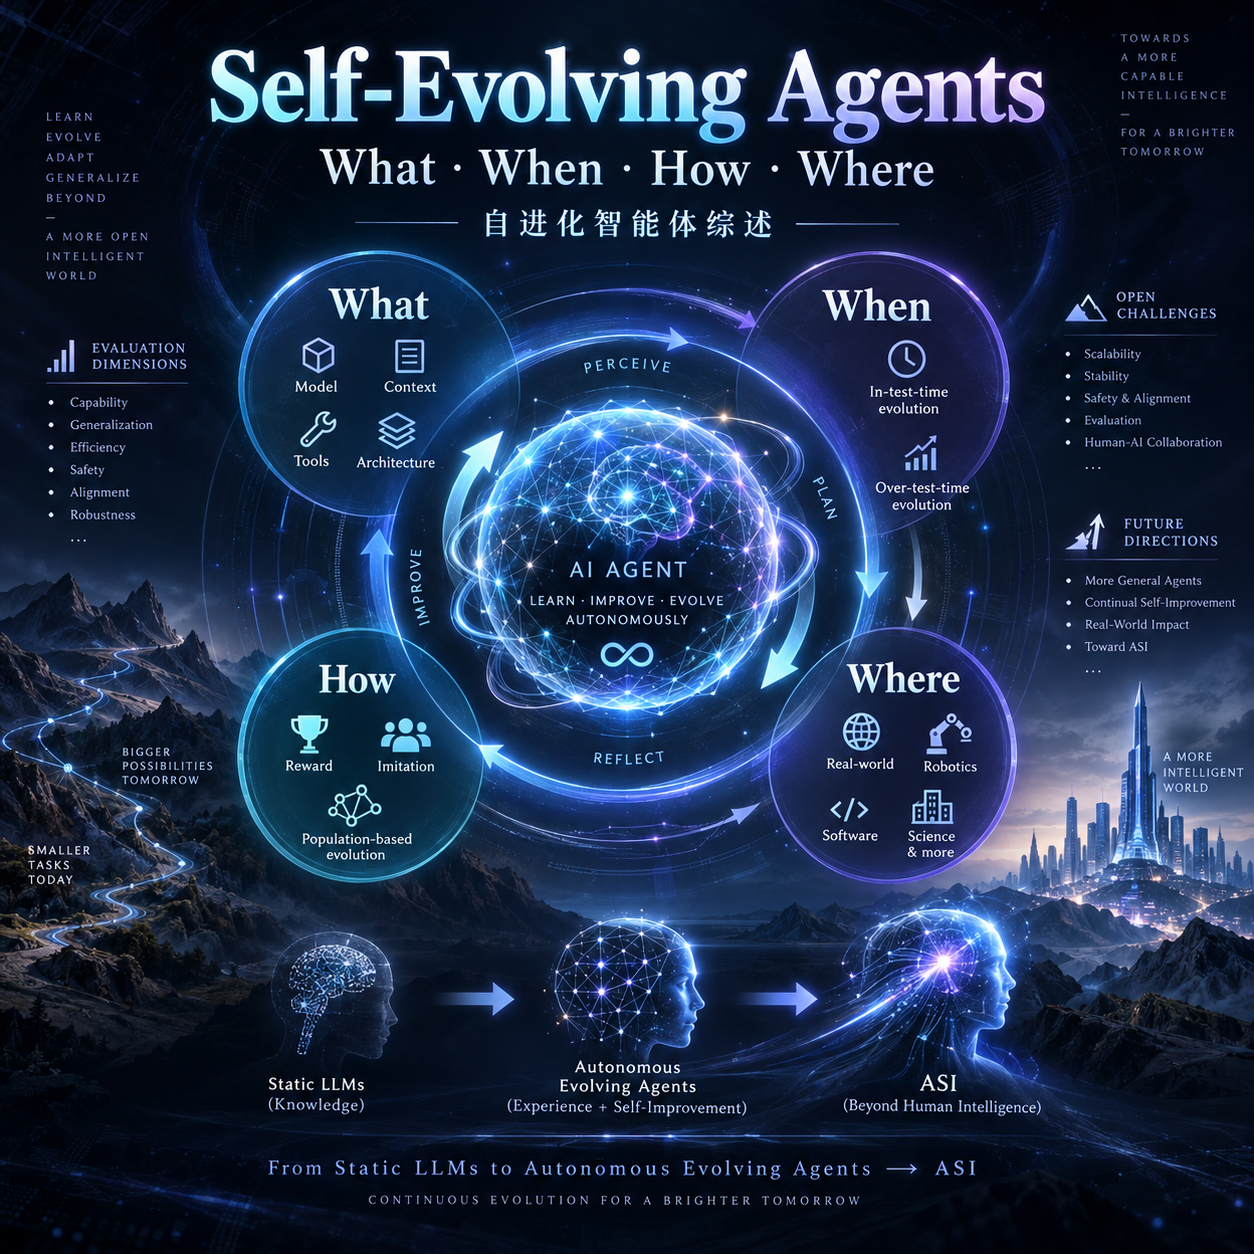
Self-Evolving Agents (What、When、How、Where) —— 自进化智能体综述
系统解读自进化智能体综述,围绕 What、When、How、Where 四大核心问题,系统梳理自进化智能体的进化对象(模型、上下文、工具、架构)、进化时机(测试时内/测试时间)、进化方法(奖励/模仿/种群)与落地领域,并涵盖五维评估体系、开放挑战与未来方向。
—热度
03
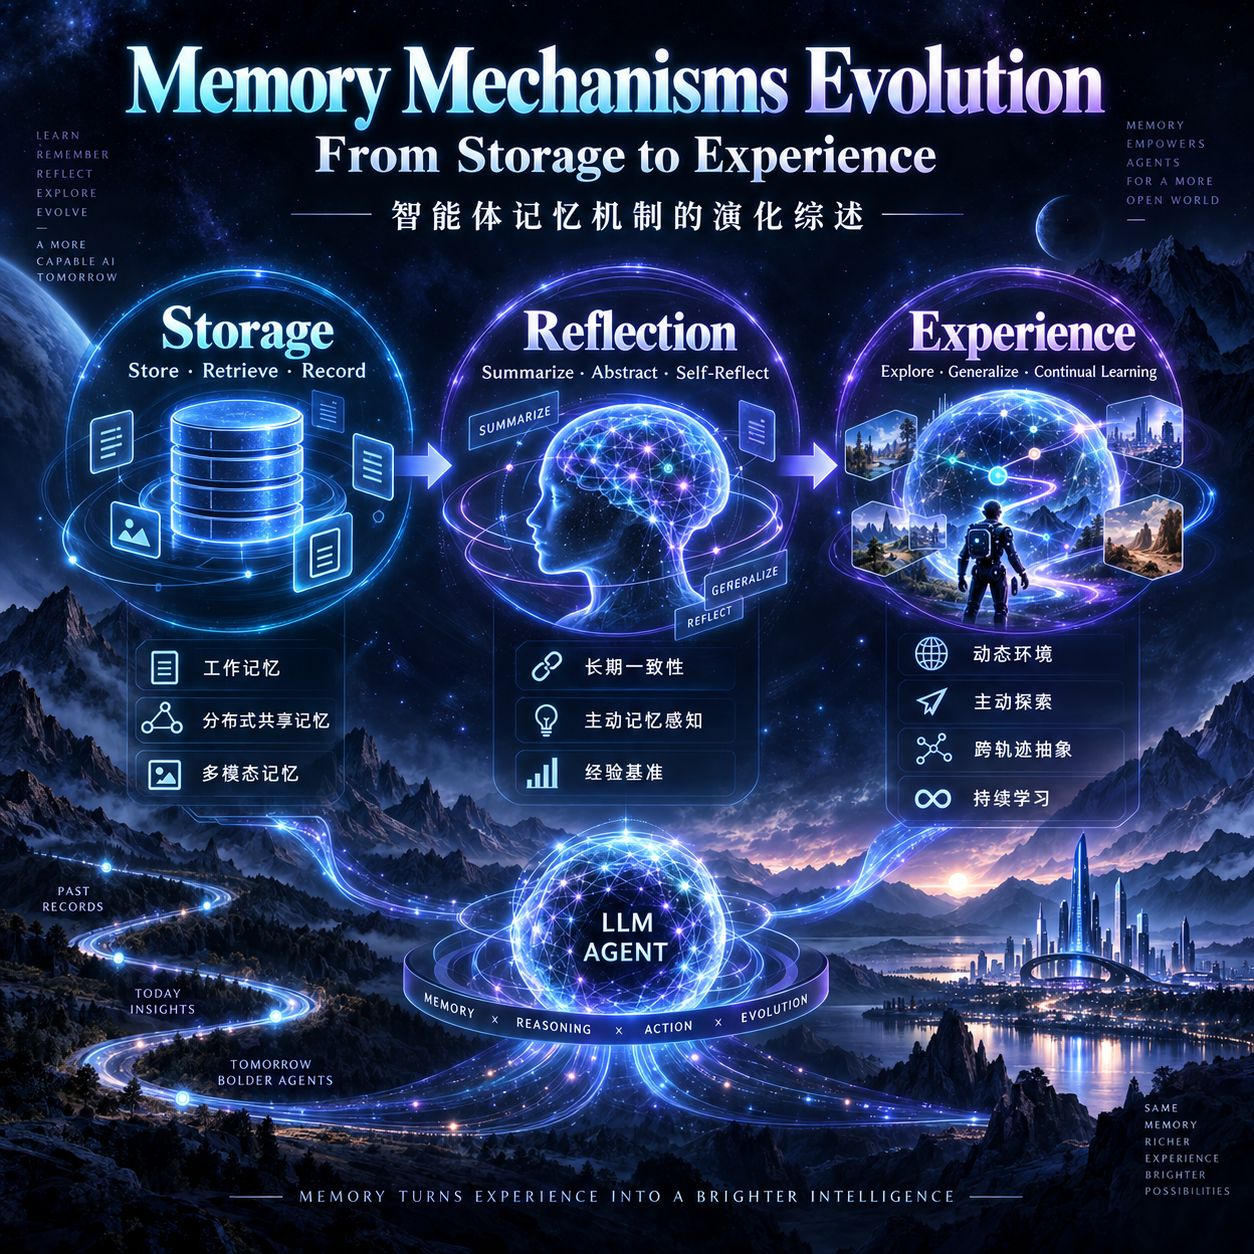
Memory Mechanisms Evolution: From Storage to Experience —— 智能体记忆机制的演化综述
系统梳理 LLM Agent 记忆机制从 Storage、Reflection 到 Experience 的演化框架。解析长期一致性、动态环境与持续学习三大驱动,剖析主动探索与跨轨迹抽象两大变革机制,并展望主动记忆感知、工作记忆、经验基准、分布式共享记忆与多模态记忆等未来方向。
—热度
04

Video Audio Multimodal —— 视频理解 & 视频生成 & 音频处理
系统讲解视频理解与生成、音频处理的核心技术:从视频的时空维度出发,剖析3D卷积与时空注意力如何建模动态信息;深入解读VideoMAE的视频Tube掩码策略与90-95%超高掩码比例的时空自监督预训练;剖析Sora视频扩散模型的核心组件及其灵活处理任意分辨率/时长视频的能力;梳理音频处理基础与Whisper的编码器-解码器架构,并介绍VALL-E将语音合成建模为条件语言模型的新范式。
—热度
05

Vision-Language-Action —— VLA具身智能
系统讲解具身智能中视觉-语言-动作模型(VLA)的核心技术:从RT-2的“动作即文本”范式出发,剖析动作Token化与Co-Fine-Tuning联合微调策略的数学原理;深入解读动作分块如何通过一次性预测未来K步动作解决时序不一致性问题;推导扩散策略中条件去噪扩散过程的噪声预测损失及其与动作分块的天作之合;并通过三维对比揭示各自优势与融合趋势。
—热度
06

Multimodal RAG —— 多模态RAG
系统讲解多模态文档检索的前沿技术ColPali:从传统OCR流水线的脆弱性出发,剖析ColPali如何通过PaliGemma视觉语言模型直接编码文档页面图像,跳过OCR与布局解析环节;深入解读延迟交互机制中MaxSim评分函数的数学原理及其相比单向量余弦相似度的精度优势;分析多粒度索引策略与跨模态查询重写技术。
—热度
07

Denoising Diffusion Probabilistic Models —— DDPM扩散模型
系统讲解扩散模型(DDPM)的数学原理与条件生成技术:从马尔可夫链的前向扩散与反向去噪出发,推导ELBO如何简化为噪声预测MSE损失;深入剖析潜空间扩散如何通过VAE压缩实现约50倍计算量降低;追溯去噪网络从U-Net到DiT的架构演进及其在Sora中的应用;解析CFG的线性外推公式及引导强度的权衡.
—热度
08

Multimodal Large Language Model —— MLLM多模态大语言模型
系统讲解多模态大语言模型(MLLM)的核心架构设计与训练范式演进:从模态连接器的三种经典方案出发,剖析视觉编码器的解冻策略与三阶段训练范式;深入探讨细粒度数据标注、幻觉缓解与评估基准;最后追溯从“拼接式”架构到原生统一架构的演进路径,揭示从“表征对齐”到“表征统一”的范式转变。
—热度
09
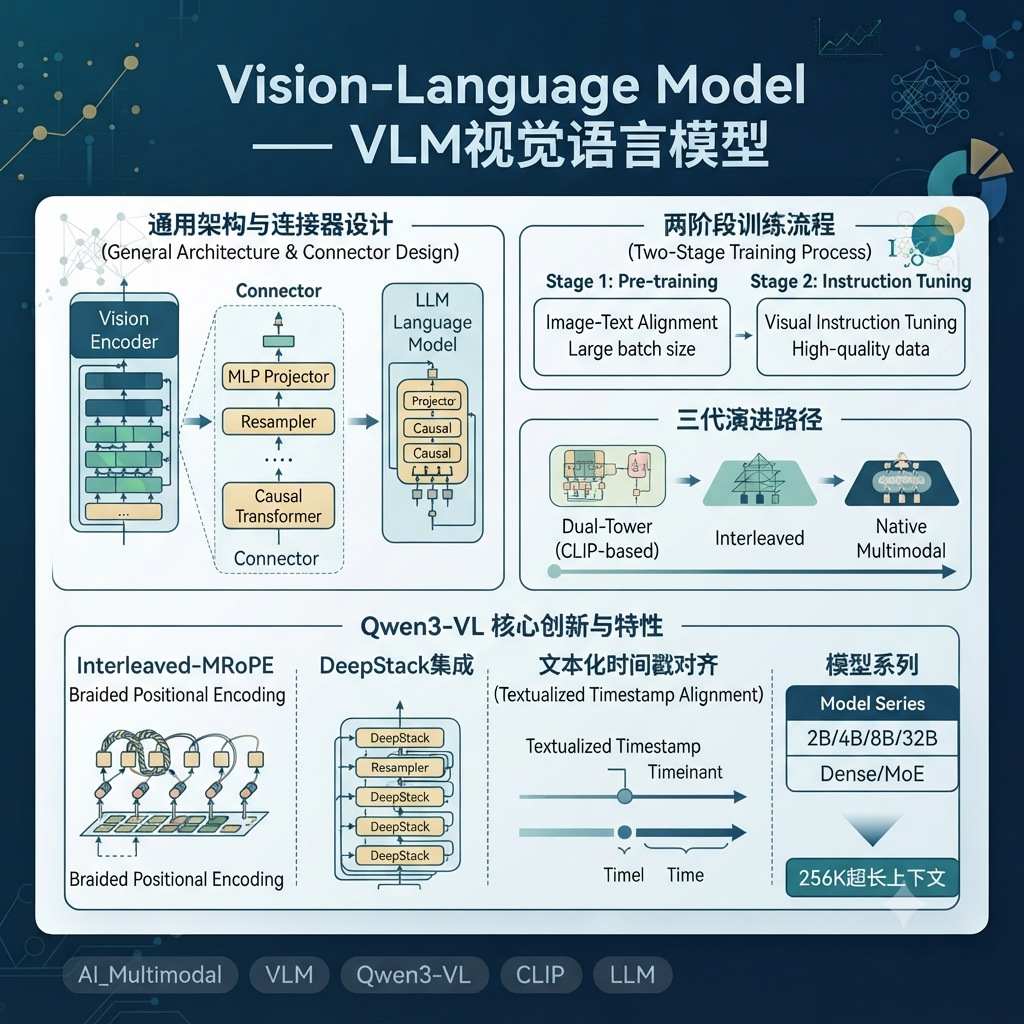
Vision-Language Model —— VLM视觉语言模型
系统讲解视觉语言模型(VLM)的通用架构,深入对比三种主流连接器方案的设计权衡;详细剖析两阶段训练流程及其目标差异;梳理从双塔架构到原生多模态的三代演进路径;最后深度解析Qwen3-VL的三项核心创新——Interleaved-MRoPE、DeepStack集成、文本化时间戳对齐,及其2B/4B/8B/32B稠密和MoE架构的模型系列与256K超长上下文特性。
—热度
10

Vision Transformer —— ViT视觉Transformer
系统讲解视觉Transformer(ViT)的核心机制与技术演进:从Patch Embedding与位置嵌入的基础原理出发,对比ViT与CNN在归纳偏置上的根本差异及DeiT通过知识蒸馏弥补数据效率的尝试;深入剖析Swin Transformer的窗口注意力与层级化特征表示、可变形注意力的动态聚焦机制;系统梳理高分辨率适配的三条技术路线——AnyRes/LLaVA-UHD的切图融合策略、NaViT/ViTAR的原生动态分辨率方案、以及RoPE/插值/LookHere等位置编码外推方法。
—热度
11

Contrastive Language-Image Pre-training —— CLIP对比学习
系统讲解CLIP的核心原理与技术演进:从双塔架构出发,推导InfoNCE损失函数的数学本质及其与交叉熵的等价性;剖析WIT-400M大规模图文对预训练的工程挑战;深入解读零样本分类的工作原理;并介绍SigLIP如何通过Sigmoid损失替代Softmax归一化,实现更优的小批次训练效率与灵活性。
—热度
12

RLVR (Reinforcement Learning with Verifiable Rewards) —— 可验证奖励强化学习
系统梳理RLVR(Reinforcement Learning with Verifiable Rewards)的核心思想、数学形式化、主流算法(PPO、GRPO、PACS、ROVER)及训练流程,对比RLHF与RLVR的本质差异,并探讨验证器可靠性、奖励稀疏等核心挑战与前沿解决方案。
—热度
13

Comparison of RL Algorithm —— PPO、GRPO、DPO、DAPO、GSPO技术详解与对比
从12个核心维度系统对比PPO、GRPO、DPO、DAPO与GSPO五种大模型强化学习对齐算法,剖析其技术演进脉络、核心机制与适用场景,揭示从"通用重器"到"专属利刃"的进化逻辑。
—热度
14

GSPO (Group Sequence Policy Optimization) -- 群组序列策略优化
系统梳理GSPO群组序列策略优化的核心原理,解析其如何通过序列级重要性比率与长度归一化从根本上修复GRPO的token级采样缺陷,解决MoE专家震荡与长序列方差累积问题,并探讨GSPO的局限与后续演进。
—热度
15

DAPO (Decoupled Clip and Dynamic sAmpling Policy Optimization) -- 解耦裁剪与动态采样策略优化
系统梳理DAPO解耦裁剪与动态采样策略优化的核心技术原理,解析Clip-Higher、Dynamic Sampling、Token-Level Loss与Overlong Reward Shaping四项创新如何解决GRPO在长CoT场景下的熵崩塌与训练不稳定问题,将GRPO从实验室算法打磨为工业级系统。
—热度
16

GRPO (Group Relative Policy Optimization) -- 群体相对策略优化
系统梳理GRPO群体相对策略优化的核心原理、组内相对优势估计机制与训练流程,解析其如何通过移除价值网络实现显存占用降低40%以上,并对比GRPO与PPO、DPO的差异及各自适用场景。
—热度
17

DPO (Direct Preference Optimization) -- 直接偏好优化
系统梳理DPO直接偏好优化的核心原理、数学推导与实现机制,解析其如何将RLHF的多阶段流程简化为单阶段监督学习,并对比DPO与PPO的差异及各自适用场景。
—热度
18

PPO(Proximal Policy Optimization) -- 近端策略优化
系统梳理PPO近端策略优化的核心思想、目标函数、训练流程与优缺点,解析其在LLM强化学习对齐中的应用,并探讨PPO的局限与后续演进方向。
—热度
19
Reinforcement Learning -- 策略梯度、优势函数、重要性采样与KL散度惩罚
系统梳理策略梯度、优势函数、重要性采样与KL散度惩罚的核心概念,串联从VPG到PPO的技术演进逻辑,并探讨On-Policy与Off-Policy的权衡及数据漂移问题。
—热度
20

RLHF (Reinforcement Learning from Human Feedback) —— 基于人类反馈的强化学习
系统拆解RLHF的三步流程、核心算法原理、代码实现细节以及面临的挑战,涵盖SFT、奖励模型训练、PPO优化、奖励黑客等核心议题,并探讨DPO、RLAIF等演进方向。
—热度
21

SFT (Supervised Fine-Tuning)—— 监督微调
深入剖析监督微调(SFT)的核心原理,涵盖最大似然估计与交叉熵损失的数学推导、Loss Masking 代码实现、灾难性遗忘与不完全学习现象(ILP)等系统挑战,以及数据质量、分层学习率等最佳实践。全面理解 SFT 作为 LLM 后训练基石的定位、优势与演进方向。
—热度
22

PEFT (Parameter-Efficient Fine-Tuning) —— 参数高效微调
系统解析PEFT技术体系,涵盖Adapter Tuning、Prefix Tuning、Prompt Tuning、LoRA、QLoRA、AdaLoRA、IA3等核心方法的数学原理、代码实现与选型指南,探讨低秩假设、矩阵分解、参数重参数化等深刻思想,以及前沿进展与未来方向。
—热度
23

Multi-Agent System—— 多智能体系统
系统讲解多Agent协作的架构模式与决策协议:从单Agent的指令迷雾与工具过载问题出发,剖析顺序流水线、层级委托与对等协商三种协作模式的数学建模与适用场景;深入评估投票、共识与法官裁决三种决策协议的任务适配性;分析MAD多智能体辩论中多数投票的核心贡献与辩论本身的局限性,以及MoA混合智能体通过模型多样性实现性能提升的集成范式。
—热度
24

Agent Communication Protocols —— MCP & A2A
系统讲解AI Agent通信协议MCP(模型上下文协议)与A2A(Agent2Agent协议)的定位差异、技术架构与协同方式。从MCP的客户端-服务器架构及其Tools/Resources/Prompts三种能力出发,到A2A的AgentCard发现机制与任务生命周期管理,通过六维对比分析揭示两者在连接对象、通信模式、扩展方式上的本质区别,并论证“MCP给Agent装备工具,A2A让Agent组网协作”的互补关系。
—热度
25

Agent Engineering —— Prompt & Context & Harness & Loop
系统剖析AI Agent工程从Prompt Engineering到Context Engineering再到Harness Engineering的三层演进路径:以数学公式形式化Prompt如何塑造条件概率分布、Context如何通过装配方程治理信息环境、Harness如何通过七层架构构建执行控制框架,并探讨Loop Engineering作为第四层延伸的嵌套关系。
—热度
26

Memory System —— Agent记忆系统
系统讲解AI Agent记忆系统的架构设计与工程实践:从向量数据库作为记忆存储底座出发,剖析记忆生命周期的写入、检索、更新与遗忘策略,深入解读MemGPT如何借鉴操作系统分层内存管理思想将LLM上下文窗口视为“物理内存”、外部向量库视为“磁盘”以实现无限上下文幻觉,并介绍记忆压缩在有限空间中高效存活的机制。
—热度
27

Retrieval-Augmented Generation —— 检索增强生成
系统讲解检索增强生成(RAG)的核心技术原理与工程实践:从文档分块的三种策略及其适用场景,到向量检索中ANN算法的数学原理与选型指南,再到重排序阶段Bi-Encoder与Cross-Encoder的架构差异及其对MRR/NDCG的量化提升,最后介绍HyDE如何通过“假设性文档”将检索从关键词匹配升级为意图理解。
—热度
28

Function Calling —— 工具调用
系统讲解AI Agent工具调用的核心技术原理与工程实践:从JSON Schema的结构化约束机制出发,剖析Structured Outputs如何动态屏蔽非法token以保证输出匹配Schema;分析并行工具调用的延迟优势;深入解读tools与tool_choice的设计哲学;揭示工具描述撰写的核心技巧。
—热度
29

Agent Paradigms —— ReAct & Plan-and-Solve & Reflection
系统剖析AI Agent的三大核心范式:ReAct(推理与行动交替的Thought-Action-Observation三拍循环)、Plan-and-Solve(先分解规划后逐步执行的两阶段架构)与Reflection(生成-批评-修正的自我优化机制)。从数学建模角度揭示ReAct如何通过外部观察修正条件概率分布、Plan-and-Solve如何将任务分解为子目标序列、Reflexion如何以“语义梯度”替代参数梯度实现零样本学习,并通过实验数据对比三种范式的适用场景与成本特征。
—热度
30

Agent Architecture —— LLM & Planning & Tool & Memory
系统讲解AI Agent的核心架构——LLM(推理引擎)、规划(Planning)、工具(Tools)与记忆(Memory)四大模块的设计原理与协同机制。从感知-规划-行动闭环出发,剖析LLM作为“中央推理引擎”的多重角色、规划的数学建模与两种范式、工具调用的标准化接口与MCP协议演进,以及短期记忆与长期记忆的二分法设计。
—热度
31
Transformer Inference Generation —— 推理生成式语言模型
系统讲解语言模型推理生成的完整技术栈:从自回归生成的本质出发,剖析温度采样、Top-k采样与Top-p三种生成策略的工作原理与参数调节;详解从检查点恢复训练权重的加载机制;完整拆解从原始文本到生成文本的端到端推理数据流;深入剖析KV Cache的核心原理及其代价与前沿优化方向。全文总结整个从零构建Transformer系列的技术栈全景与未来扩展方向。
—热度
32
Transformer Training Experiments —— 完整训练实战与消融实验
系统讲解基于argparse的命令行训练脚本设计与五组消融实验的科学验证:从高度参数化的训练框架出发,设计五组对照实验以量化各组件贡献;基于训练损失/验证损失/困惑度/梯度范数等多维度指标分析,得出各组件重要性排序;展示完整的训练循环实现及自动化批量实验的工程价值。附有完整命令行参数体系与实验配置。
—热度
33
Transformer Training System —— 完整训练系统
系统讲解语言模型训练的核心系统组件:从数值稳定的交叉熵损失出发,剖析基于np.memmap的高效数据加载器与随机采样批次生成逻辑;从零推导AdamW优化器的完整更新公式;设计余弦退火学习率调度器;实现基于全局L2范数的梯度裁剪以防止梯度爆炸。完整展示从数据到优化器的训练闭环。
—热度
34
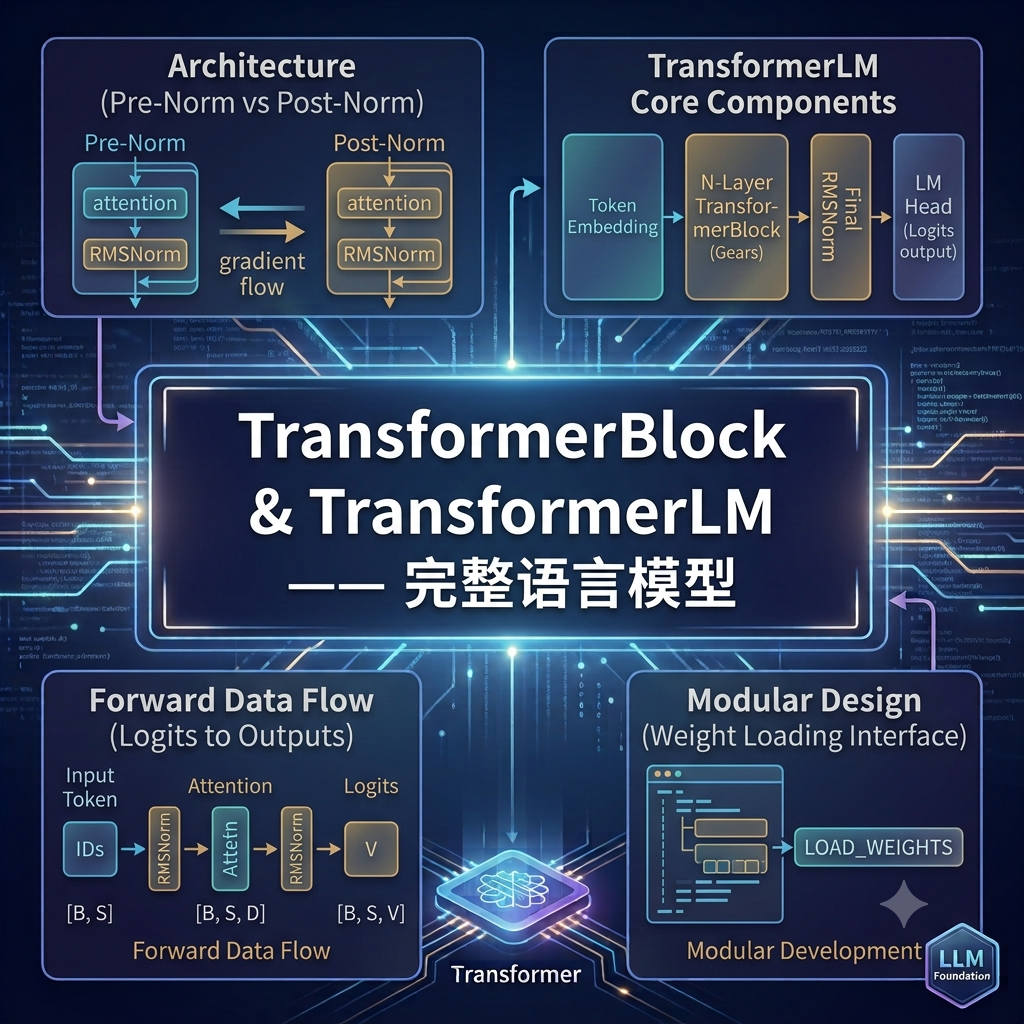
TransformerBlock & TransformerLM —— 完整语言模型
系统讲解如何将Transformer的各个组件组合成完整的可训练语言模型:从TransformerBlock的Pre-Norm与Post-Norm架构对比入手,剖析残差连接如何保障深层网络梯度流动;深入模块化设计中的权重加载接口;拆解TransformerLM四大核心组件(Token Embedding → N层TransformerBlock → Final RMSNorm → LM Head)及其超参数设计的权衡考量;完整跟踪从token ID到logits的前向传播数据流(形状变换全程)。
—热度
35
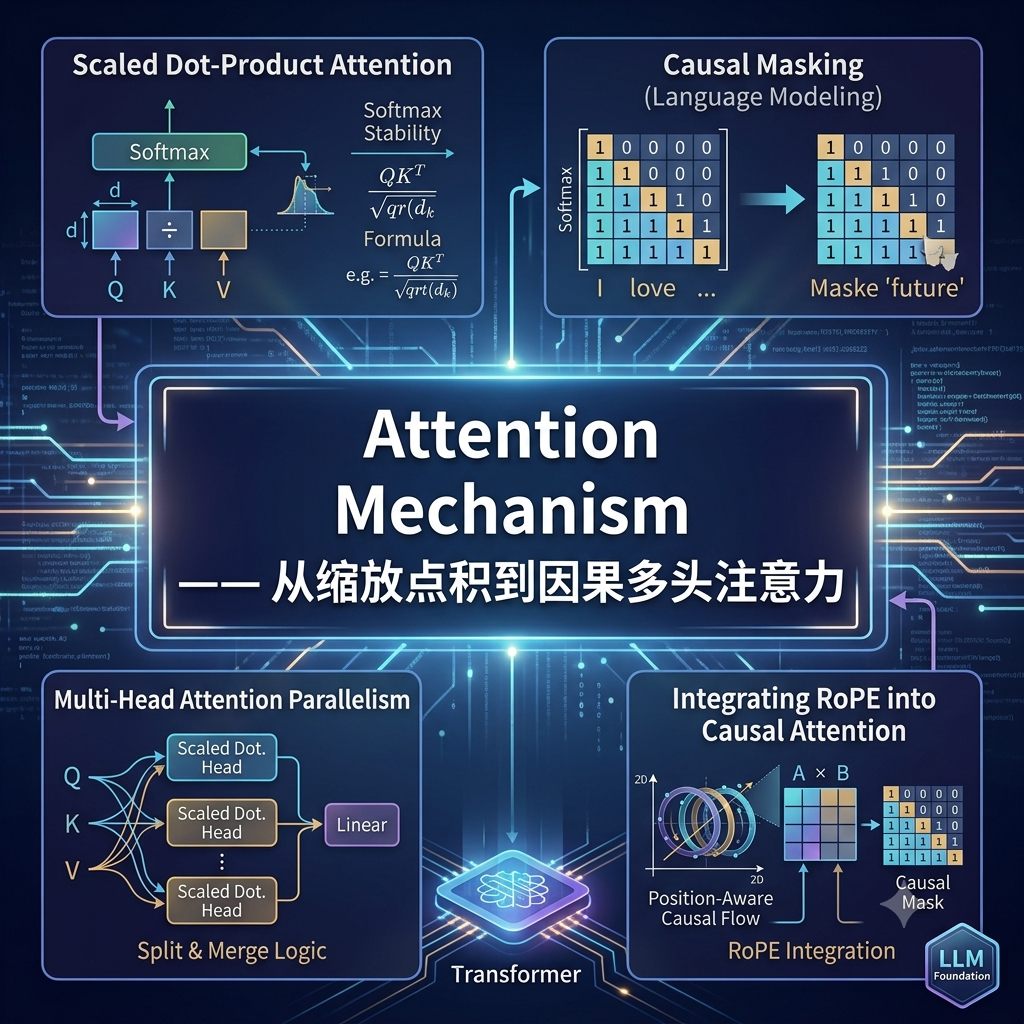
Attention Mechanism —— 从缩放点积到因果多头注意力
系统讲解Transformer注意力机制的核心原理与完整实现:从数值稳定的Softmax出发,推导缩放点积注意力的数学公式与几何意义;深入剖析因果掩码的下三角矩阵机制及其在自回归语言模型中的关键作用;详解多头注意力的拆分与合并逻辑及并行计算优势;最后阐述RoPE旋转位置编码如何直接融入注意力计算,与因果掩码协同实现带位置感知的因果注意力。
—热度
36
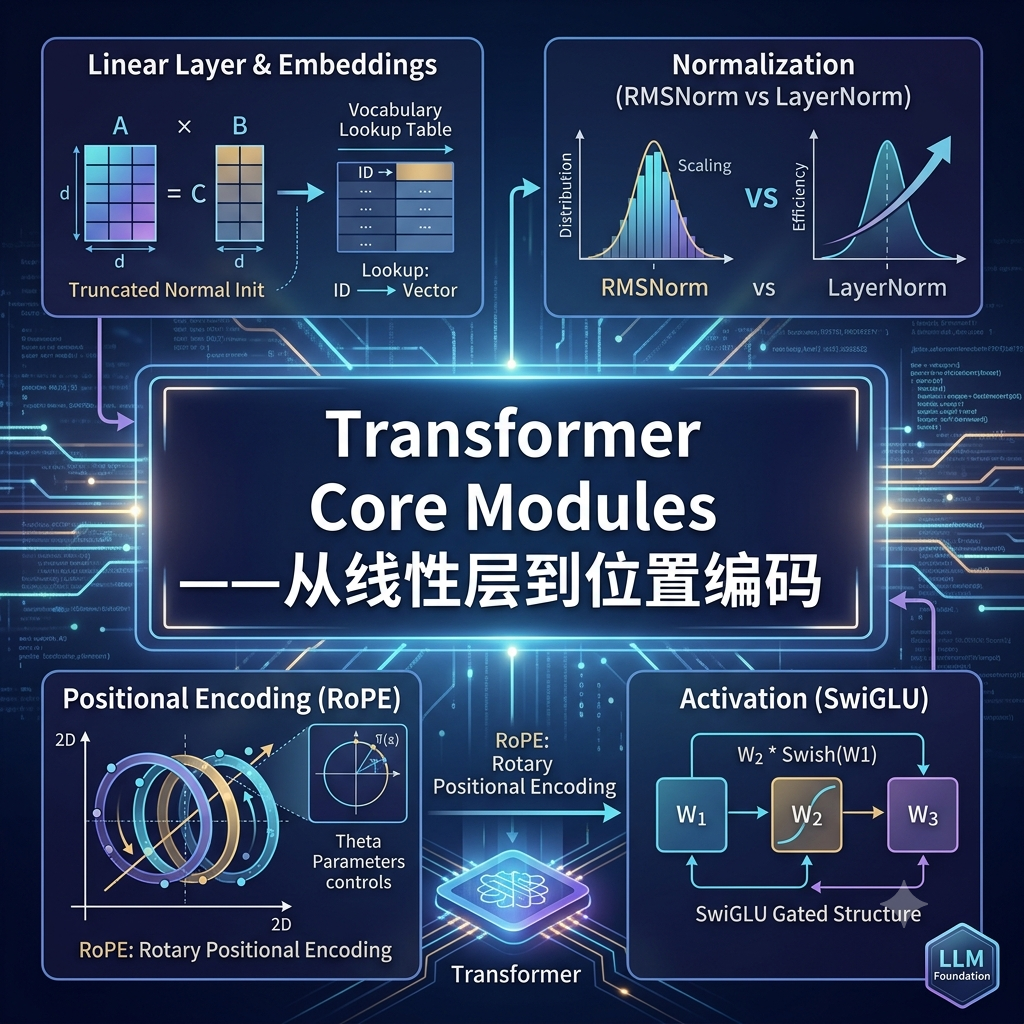
Transformer Core Modules —— 从线性层到位置编码
系统讲解Transformer核心模块的从零实现:从线性层的矩阵乘法本质与截断正态初始化策略出发,深入词嵌入层的查表机制与参数规模计算;推导RMSNorm相比LayerNorm的归一化原理与计算效率优势;剖析SwiGLU门控激活函数的三矩阵结构(W₁/W₂/W₃)及其参数量权衡;最后完整推导RoPE旋转位置编码的数学原理——从二维平面旋转矩阵到复数视角的高维扩展,以及theta参数对旋转频率的控制与编码质量的影响。
—热度
37
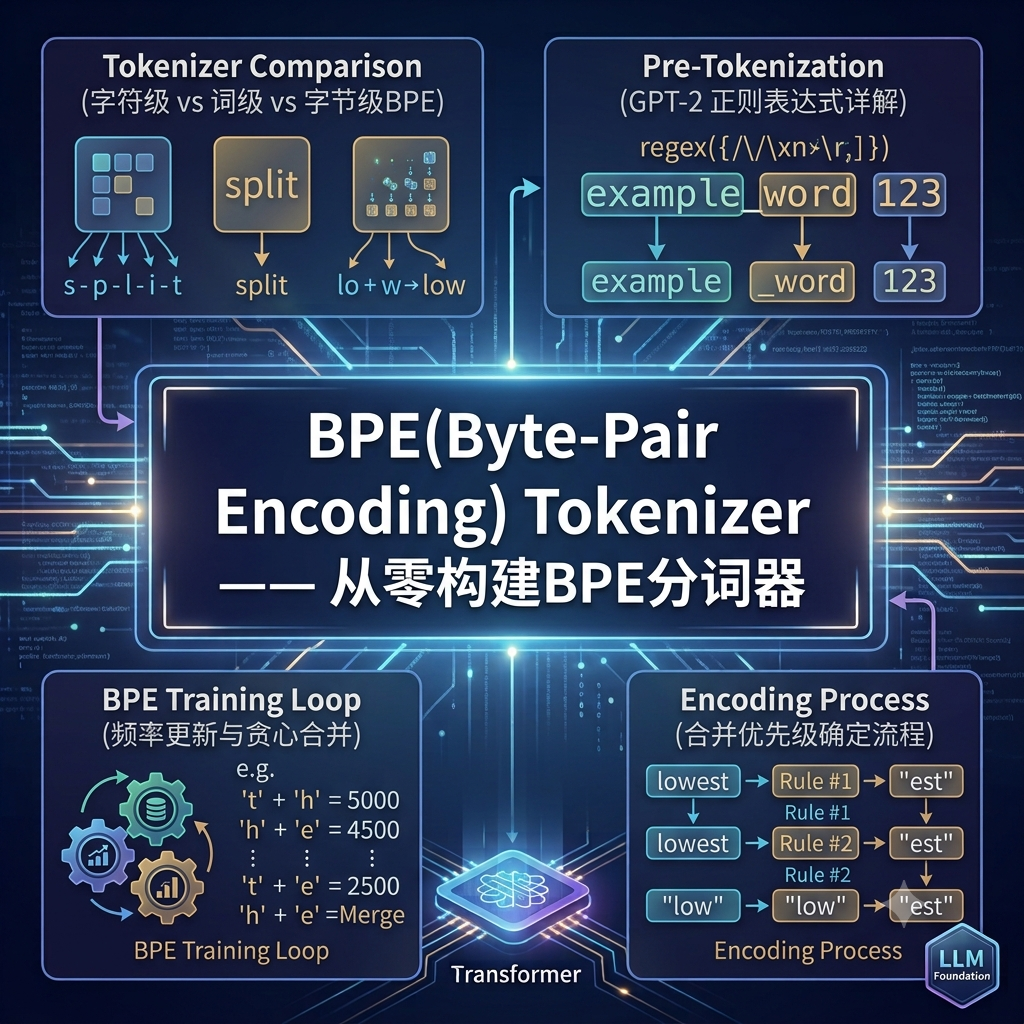
BPE(Byte-Pair Encoding) Tokenizer —— 从零构建BPE分词器
系统讲解字节级BPE(Byte-Pair Encoding)分词器的完整实现原理与代码。从词级分词与字符级分词的困境出发,剖析GPT-2风格字节级BPE的优势;详细拆解预分词阶段GPT-2正则表达式含义;深入推导BPE训练的核心数据结构与贪心合并循环的频率更新逻辑;详解编码时按合并优先级应用规则的确定性流程;最后在TinyStories数据集上训练出18,017词汇量的分词器并生成.dat文件供模型训练使用。
—热度
38

Lecture 9:LLM development
系统梳理大语言模型在跨模态与前沿技术方向的核心进展,涵盖Transformer多模态泛化本质、ViT与VLM的视觉适配方案、扩散LLMs(MDM)的并行生成突破、跨模态技术交叉融合(扩散架构/Transformer/MSRoPE/DeepSeek-OCR)、LLM基础研究趋势(帕累托优化/类存内计算)及应用场景与未来展望,最后提供学术与工程跟进渠道。
—热度
39

Lecture 8:LLM evaluation
系统梳理大语言模型评估的完整方法论体系,涵盖人工评分的黄金标准与卡帕系数一致性量化、规则化指标(METEOR/BLEU/ROUGE)的算法原理与局限、LLM-as-a-Judge(LaaJ)的核心流程与偏置缓解、事实性量化方法(Fact Decomposition)、智能体工具调用全流程故障模式与排查,以及主流基准测试(MMLU/AIME/SWE-bench/HarmBench/τ-bench)与Pass^k/帕累托前沿/数据污染等核心概念。
—热度
40

Lecture 7:Agentic LLMs
系统梳理大语言模型智能体(Agentic LLMs)的三大核心技术:检索增强生成(RAG)的构建流程、检索评估指标与优化技巧;工具调用(Tool Calling)的标准化实现(MCP协议)与训练/提示词两种调用方式;智能体(Agent)的ReAct推理-行动框架、多智能体协作协议A2A,以及LLM应用的核心挑战与工程实践原则。
—热度
41

Lecture 6: LLM Reasoning
系统梳理大语言模型推理能力的核心技术路径,涵盖推理与非推理的本质区分、思维链(CoT)范式变革、推理评估体系(Pass@k/Cons@k)、GRPO群体相对策略优化算法的数学原理与改进(DAPO/Dr.GRPO)、DeepSeek R1/R1-Zero的多阶段训练流程,以及推理链蒸馏的工程化实践。
—热度
42

Lecture 5:LLM Preference tuning
系统梳理大语言模型偏好调优(Preference Tuning)的核心技术与方法,涵盖偏好数据的三大类型(点态/成对/列表型)与获取流程、RLHF两阶段架构(奖励建模+PPO强化学习)、BoN替代方案,以及DPO的数学原理与优势,最后对比RLHF与DPO的实现难度与性能差异。
—热度
43

Lecture 4:LLM training
系统梳理大语言模型(LLM)训练的全生命周期,涵盖训练范式演变(传统→迁移→预训练+微调)、预训练目标与缩放规律(含Chinchilla定律)、训练四阶段流程(初始化→前向→反向→Adam更新)、核心内存优化(ZeRO并行/Flash Attention/混合精度)、有监督微调(SFT/指令调优),以及参数高效微调(LoRA/QLoRA)原理与模型对齐目标。
—热度
44

Lecture 3:LLM core techniques
系统梳理大语言模型(LLM)的核心技术全景,涵盖LLM定义与特征、混合专家模型(MoE)架构与路由坍缩解决方案、自回归解码策略(贪心/束搜索/采样/温度系数/引导解码)、提示工程(ICL/CoT/自一致性),以及推理优化技巧(KV缓存/GQA/PagedAttention/潜在注意力/推测解码/MTP)。
—热度
45

Lecture 2:Transformer-based models & tricks
系统梳理Transformer进阶核心模块,涵盖缩放点积与多头注意力回顾、位置编码从绝对到相对(RoPE)的演进、层归一化(Pre-Norm/RMSNorm)优化、注意力近似方法(稀疏注意力/MQA/GQA)、三大衍生架构对比,以及BERT的预训练(MLM/NSP)、微调流程与经典变体(DistilBERT/RoBERTa)。
—热度
46

Lecture 1:Transformer background and architecture
系统梳理Transformer的诞生背景与核心架构,涵盖分词策略、词表示演进、RNN/LSTM的痛点、自注意力与多头注意力机制、位置编码、编码器-解码器设计,并通过机器翻译端到端案例串联NLP完整技术栈。
—热度
47

LSTM & GRU —— 门控循环神经网络
系统讲解LSTM与GRU的门控机制设计哲学与数学原理。从LSTM的“双轨”架构(细胞状态+隐藏状态)与三门结构(遗忘门、输入门、输出门)出发,推导细胞状态更新公式如何通过按元素加法路径缓解梯度消失,并深入剖析GRU的两大简化及其参数量优势。附带讨论双向LSTM与深层堆叠LSTM的应用场景。
—热度
48

RNN & BPTT —— 循环神经网络与随时间反向传播
系统讲解循环神经网络(RNN)的数学原理与随时间反向传播(BPTT)算法。从RNN的循环结构与共享参数出发,推导BPTT的梯度表达式,揭示梯度消失与梯度爆炸的数学根源,并介绍梯度裁剪作为应对梯度爆炸的工程解法。附带讨论LSTM如何通过门控机制缓解梯度消失。
—热度
49

Residual Network —— ResNet残差网络
系统讲解ResNet残差网络的设计哲学与数学原理:从退化问题的本质出发,推导残差块F(x)+x如何通过恒等映射直通路径缓解梯度消失,详解Bottleneck块如何将参数量减少约94%,并对比ResNet(加法融合)与DenseNet(拼接融合)的梯度流动差异。
—热度
50

CNN —— 卷积神经网络
系统讲解卷积神经网络(CNN)的四大核心操作:从严格卷积与互相关的数学区别出发,推导感受野的递推计算公式,剖析空洞卷积如何在不增加参数的前提下扩大感受野,详解Max Pooling与Average Pooling的反向传播机制,以及1×1卷积的跨通道信息整合、降维/升维与增加非线性的三大作用。
—热度
51

Gradient Descent Optimizer —— 梯度下降优化器
系统梳理梯度下降优化器的完整进化路径:从BGD、SGD到MBGD的效率与稳定性权衡,从动量法与NAG解决峡谷地形震荡,到AdaGrad实现参数级学习率、RMSProp引入指数加权平均解决学习率消亡,最终融合为集大成者Adam,并深入剖析AdamW如何通过解耦权重衰减修复Adam的正则化失效问题。
—热度
52

MLP & Back Propagation —— 多层感知机与反向传播
系统讲解多层感知机(MLP)的前向传播矩阵运算与反向传播链式法则,以计算图为工具手动推导3层MLP的误差回传与参数梯度公式,提炼出误差回传、权重梯度、偏置梯度的核心公式。同时讨论通用近似定理(UAT)的砖块构造直觉,以及Batch Normalization训练时mini-batch统计与推理时滑动平均(EMA)机制。
—热度
53

Autograd & Computational Graph —— 自动微分与计算图
系统讲解自动微分与计算图的底层原理:从计算图的有向无环图(DAG)结构出发,剖析链式法则是反向传播的“数学引擎”,阐明雅可比矩阵与海森矩阵的几何意义与计算方式,深入解析PyTorch中retain_graph与create_graph的区别与应用场景,对比静态图与动态图的底层哲学差异,并通过手写微型自动微分框架揭示Autograd的本质实现。
—热度
54

Activation & Initialization —— 激活函数与权重初始化
系统讲解激活函数与权重初始化的协同演进关系。从Sigmoid/Tanh的梯度饱和问题出发,推导ReLU及其变体(LeakyReLU、PReLU、ELU、GELU、Swish)如何解决梯度消失,并深入推导Xavier初始化(适用于Sigmoid/Tanh)和Kaiming初始化(适用于ReLU)的方差守恒数学原理。
—热度
55

Probability & Information —— 概率论与信息论基础
系统讲解深度学习中的概率论与信息论基础:从联合分布、边缘化与贝叶斯定理出发,推导最大似然估计(MLE)的完整四步流程并揭示其与MSE/交叉熵损失的联系,引入最大后验(MAP)估计并阐明L2/L1正则化与高斯/拉普拉斯先验的对应关系,深入剖析KL散度的非对称性及其方向含义,最后证明KL散度、交叉熵与MLE三者的数学等价性。
—热度
56

Tensor Operations —— 向量、矩阵与张量运算
系统讲解深度学习中的线性代数基础:从张量的维度与Shape变换出发,深入区分Hadamard积(*)与矩阵乘法(@)的本质差异,解析L1/L2/Frobenius范数的几何意义与机器学习用途,并直观理解特征分解的“换基→缩放→换回”几何解释,以及SVD在降维与数据压缩中的核心价值。
—热度
57
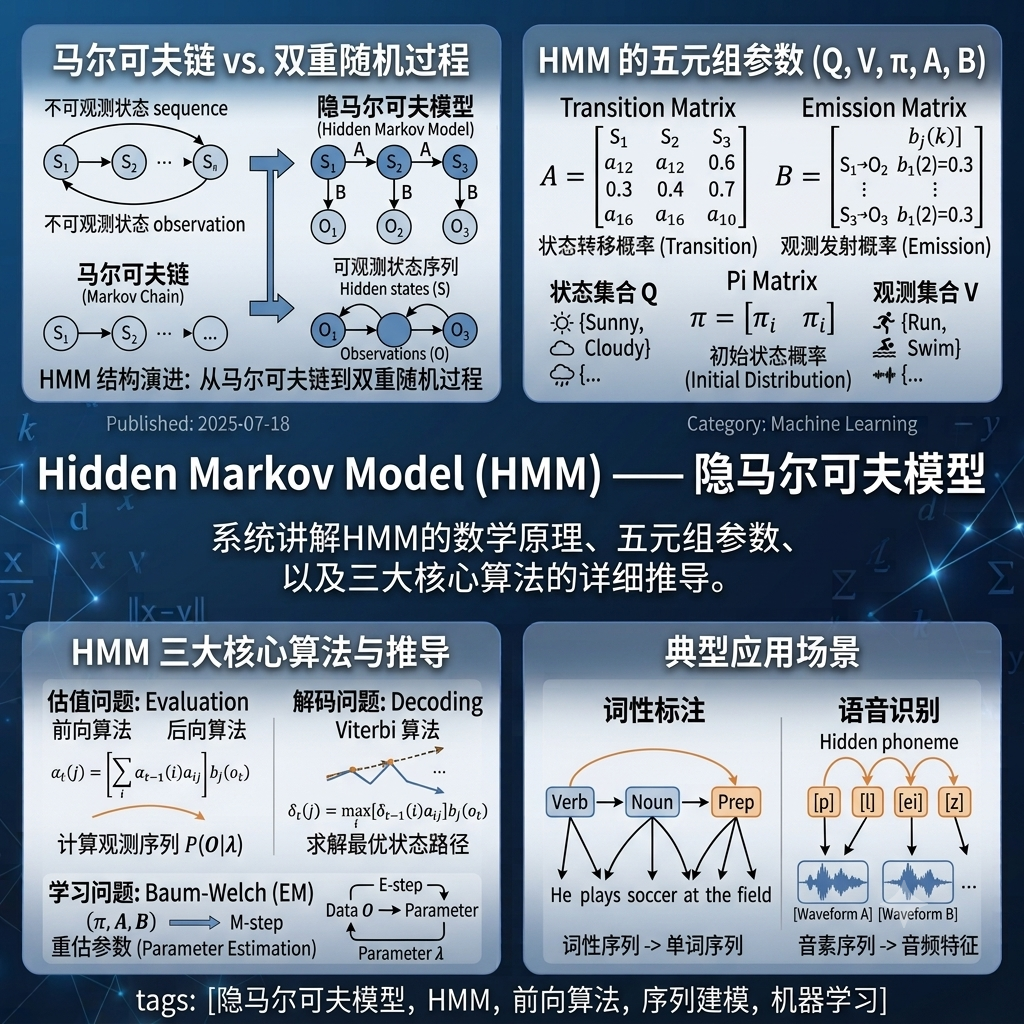
Hidden Markov Model (HMM) —— 隐马尔可夫模型
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
—热度
58
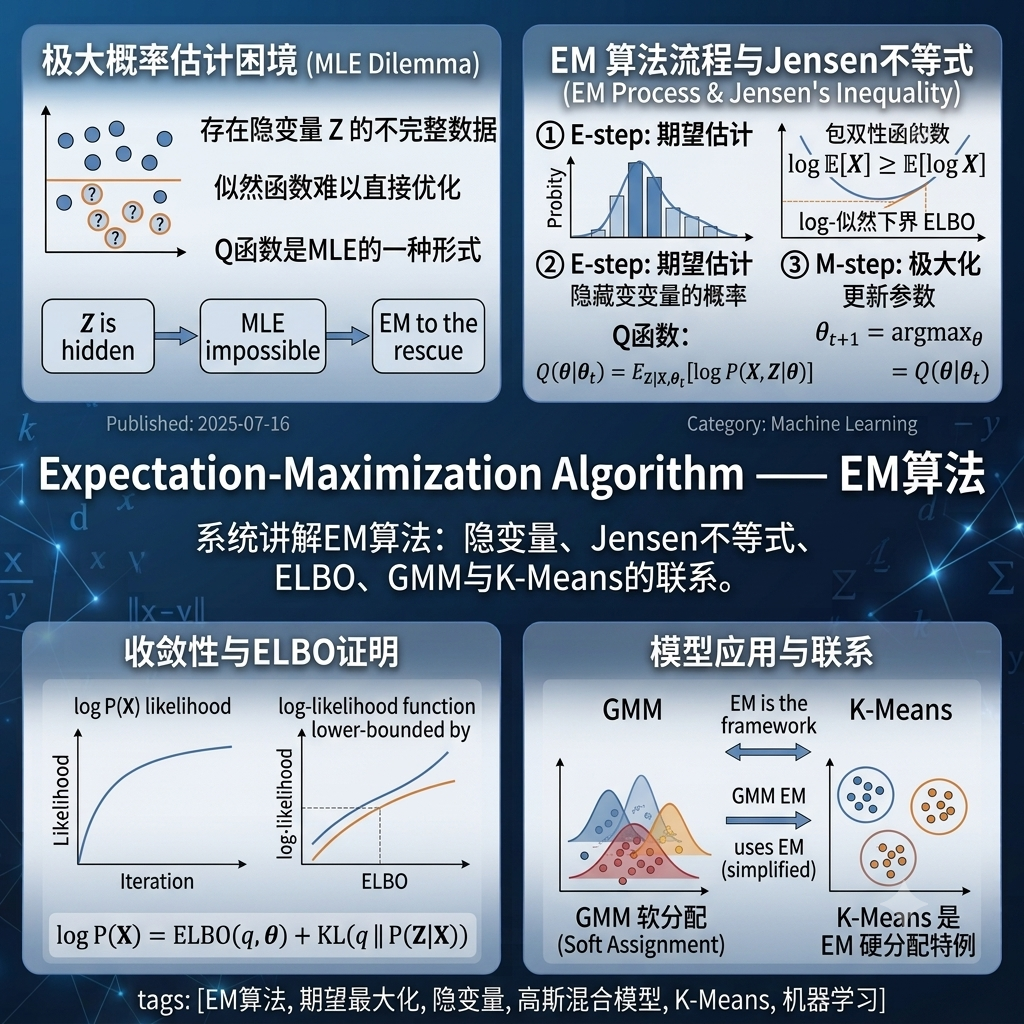
Expectation-Maximization Algorithm —— EM算法
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
—热度
59

K-Means Clustering —— 聚类算法
系统讲解K-Means聚类的核心原理与算法细节,涵盖Lloyd交替优化算法的收敛性分析、K-Means作为EM算法特例的理论联系(硬分配 vs 软分配)、K-Means++初始化策略的D²采样机制与O(log K)近似保证,以及肘部法则与轮廓系数的选择K值方法及其局限。
—热度
60
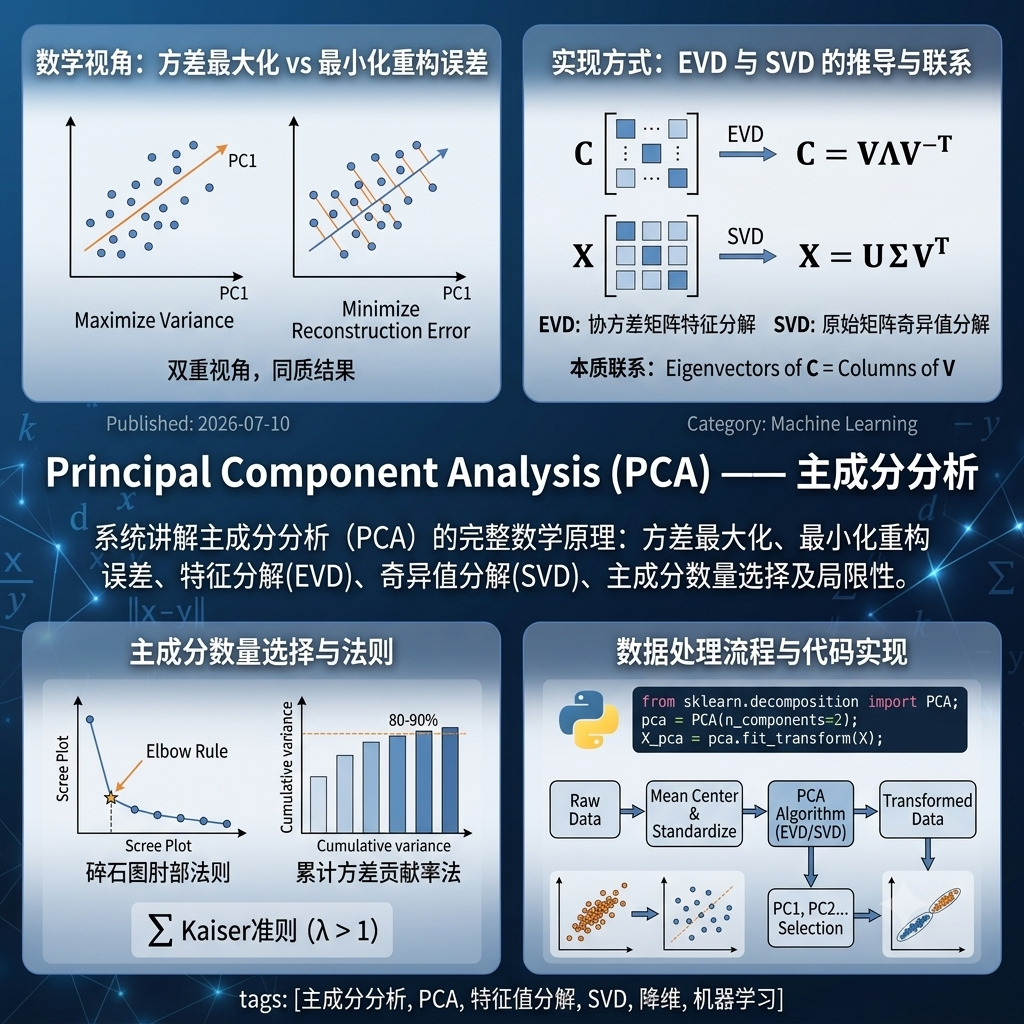
Principal Component Analysis (PCA) —— 主成分分析
系统讲解主成分分析(PCA)的完整数学原理:从方差最大化与最小化重构误差两个等价视角出发,通过拉格朗日乘子法推导出协方差矩阵的特征方程,揭示特征向量即主成分方向、特征值即主成分方差的本质联系;深入对比EVD与SVD两种实现方式的优劣与适用场景;详细介绍三种主成分数量选择方法;讨论PCA的假设和局限。
—热度
61

XGBoost & LightGBM —— 梯度提升框架
系统解析XGBoost与LightGBM两大梯度提升框架的核心工程优化技术。涵盖XGBoost的二阶泰勒展开与正则化项的数学推导、预排序与Block并行架构;LightGBM的直方图算法、GOSS梯度采样、EFB互斥特征捆绑三大加速技术,以及Level-wise与Leaf-wise树生长策略的对比。
—热度
62

Gradient Boosting Machine (GBM) —— 梯度提升机与加法模型
系统推导梯度提升机(GBM)的数学原理,从加法模型与前向分步算法出发,深入剖析“拟合负梯度”在函数空间梯度下降中的核心地位,通过偏差-方差分解对比GBM与随机森林的本质差异,并分析GBM对异常值敏感的根本原因及缓解策略(鲁棒损失函数、学习率、子采样)。
—热度
63
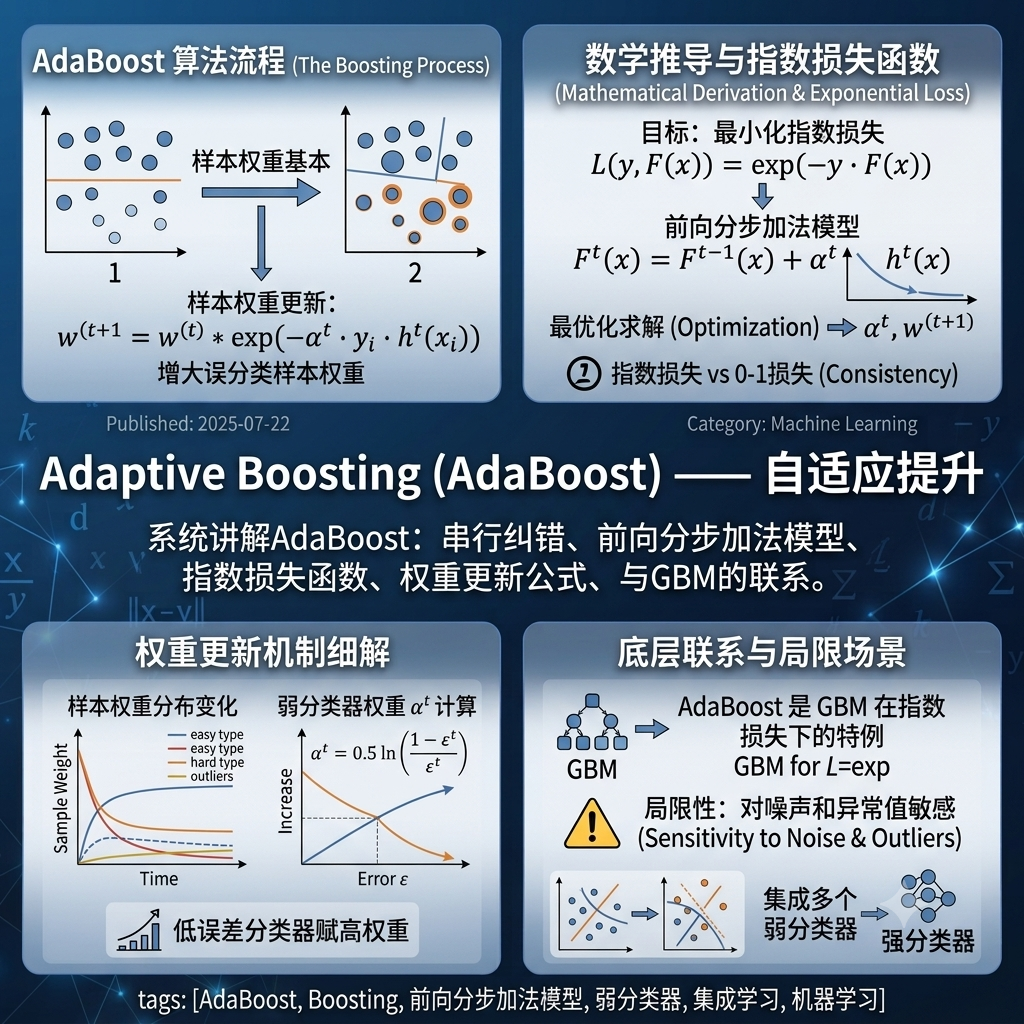
Adaptive Boosting (AdaBoost) —— 自适应提升
系统讲解AdaBoost算法的完整数学原理:从Boosting的串行纠错思想出发,推导前向分步加法模型与指数损失函数的等价性,通过最优化求解揭示弱分类器权重和样本权重更新公式的数学来源;深入分析指数损失与0-1损失的一致性及其对异常值的敏感性;阐明AdaBoost是GBM在指数损失下的特例这一底层联系。
—热度
64

Bagging & Random Forest —— 随机森林
系统讲解集成学习的核心思想,从Bootstrap自助采样的数学原理出发,深入剖析Bagging的方差降低机制、随机森林的双重随机性(行采样+列采样)、OOB误差的理论基础与实用价值,并对比基尼重要性与排列重要性两种特征重要性计算方法。
—热度
65

Decision Tree —— 决策树
系统讲解决策树家族的三大经典算法(ID3、C4.5、CART)及其分裂准则的数学原理(信息增益、信息增益率、基尼指数、MSE),深入剖析预剪枝与后剪枝(CCP成本复杂度剪枝)的策略与权衡,并解释决策树对特征尺度不敏感的深层原因。
—热度
66

Kernel Trick —— 核技巧与常用核函数
系统讲解核方法的数学原理与常用核函数的映射本质。涵盖核函数的定义、Mercer定理作为核方法的理论基石、核技巧将线性SVM对偶问题中的内积替换为核函数从而优雅处理非线性问题、多项式核的有限维映射与RBF(高斯)核的无穷维映射,以及RBF核中gamma参数对过拟合与欠拟合的影响与调优策略。
—热度
67

Support Vector Machine (SVM) —— 支持向量机
系统讲解支持向量机的完整数学推导与核心原理。涵盖函数间隔与几何间隔的定义及差异、硬间隔SVM的原始问题、拉格朗日对偶推导与KKT条件、软间隔SVM通过松弛变量与惩罚参数C处理线性不可分数据、Hinge Loss作为SVM损失函数的等价视角,以及SVM与逻辑回归在离群点鲁棒性上的本质差异。
—热度
68

Naive Bayes —— 朴素贝叶斯
系统讲解朴素贝叶斯的数学原理与三种分布假设(高斯、多项式、伯努利)的适用场景,深入剖析条件独立假设与拉普拉斯平滑的数学动机,对比生成式模型与判别式模型的本质差异,并揭示朴素贝叶斯在文本分类中表现出色的深层原因。
—热度
69

K-Nearest Neighbor (KNN) —— K-近邻
全面剖析 KNN 算法的核心机制、KD-Tree 与 Ball-Tree 的加速原理与适用场景,深入揭示维度灾难导致高维欧氏距离失效的数学根源,并强调特征标准化对 KNN 的必要性。
—热度
70

Logistic Regression —— 逻辑回归与Softmax多分类
系统讲解逻辑回归与Softmax多分类的核心原理与完整数学推导。涵盖Sigmoid函数的概率映射与导数特性、对数几率与线性决策边界、最大似然估计推导二分类交叉熵损失及梯度下降求解、Softmax回归从二分类到多分类的自然推广、Log-Sum-Exp数值稳定性技巧,以及宏平均与微平均F1-Score在多分类评价中的适用场景与代码实现。
—热度
71

Linear Regression —— 线性回归
系统讲解线性回归模型的核心原理与演进路径,涵盖最小二乘法(OLS)的矩阵推导与正规方程、Ridge(L2)正则化的闭式解与收缩特性、Lasso(L1)正则化的稀疏性来源、ElasticNet 的组合优势,以及 MSE/RMSE/MAE 评价指标的适用场景与异常值敏感性对比。
—热度
72
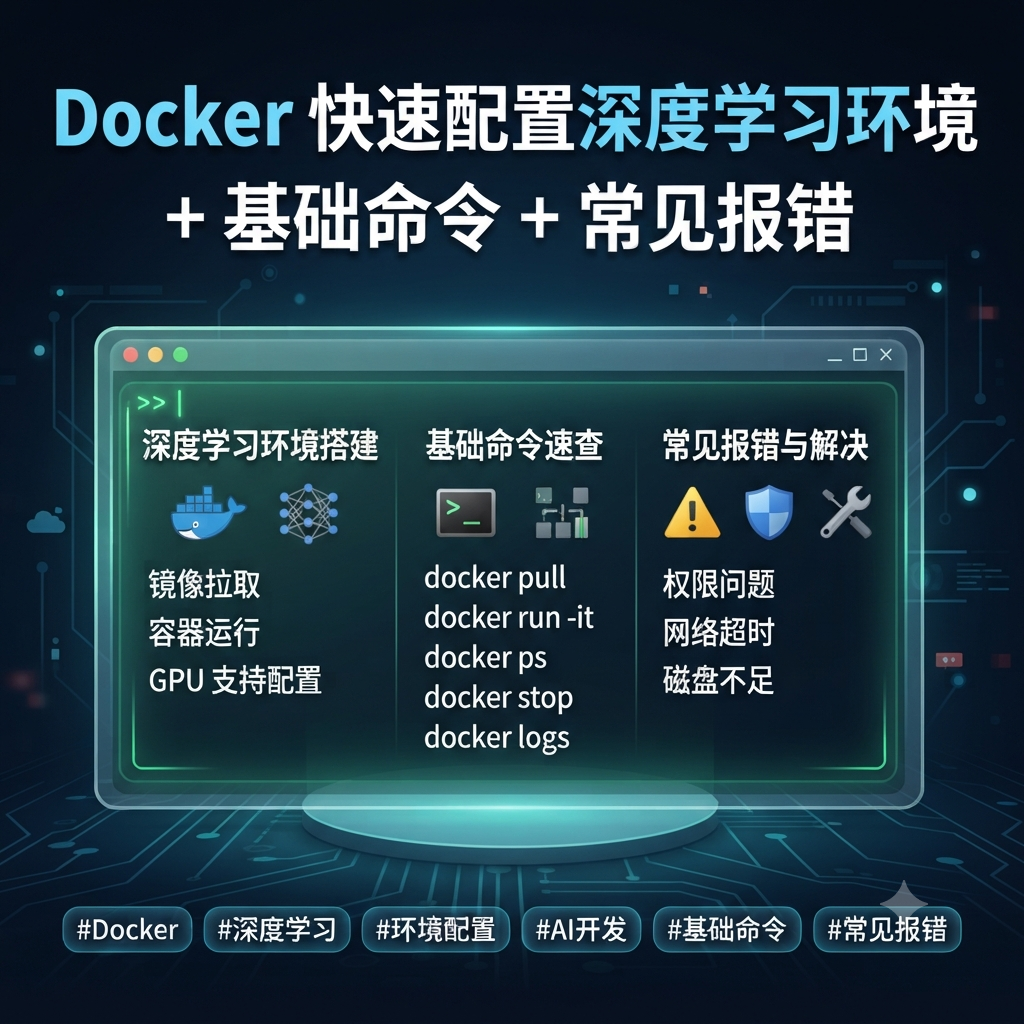
Docker 快速配置深度学习环境 + 基础命令 + 常见报错
从零搭建深度学习 Docker 环境,涵盖镜像拉取、容器运行、GPU 支持配置、基础命令速查及常见报错(权限、网络超时、磁盘不足)解决方案,助你快速上手容器化 AI 开发。
—热度
73
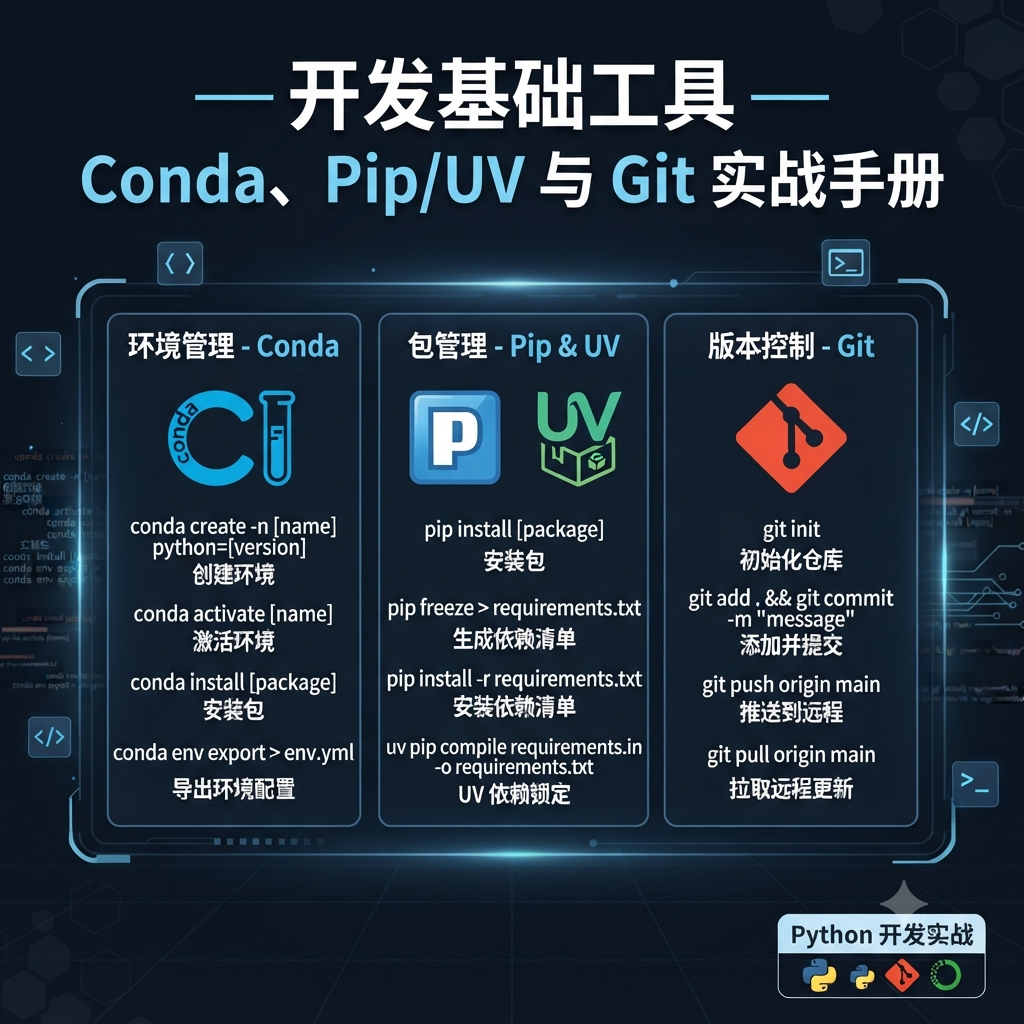
开发基础工具 —— Conda、Pip/UV 与 Git 实战手册
系统梳理 Python 开发中的环境管理(Conda)、包管理(Pip & UV)与版本控制(Git)核心命令与最佳实践,涵盖从虚拟环境配置到项目依赖锁定、从日常提交到分支管理的全流程操作指南。
—热度
74
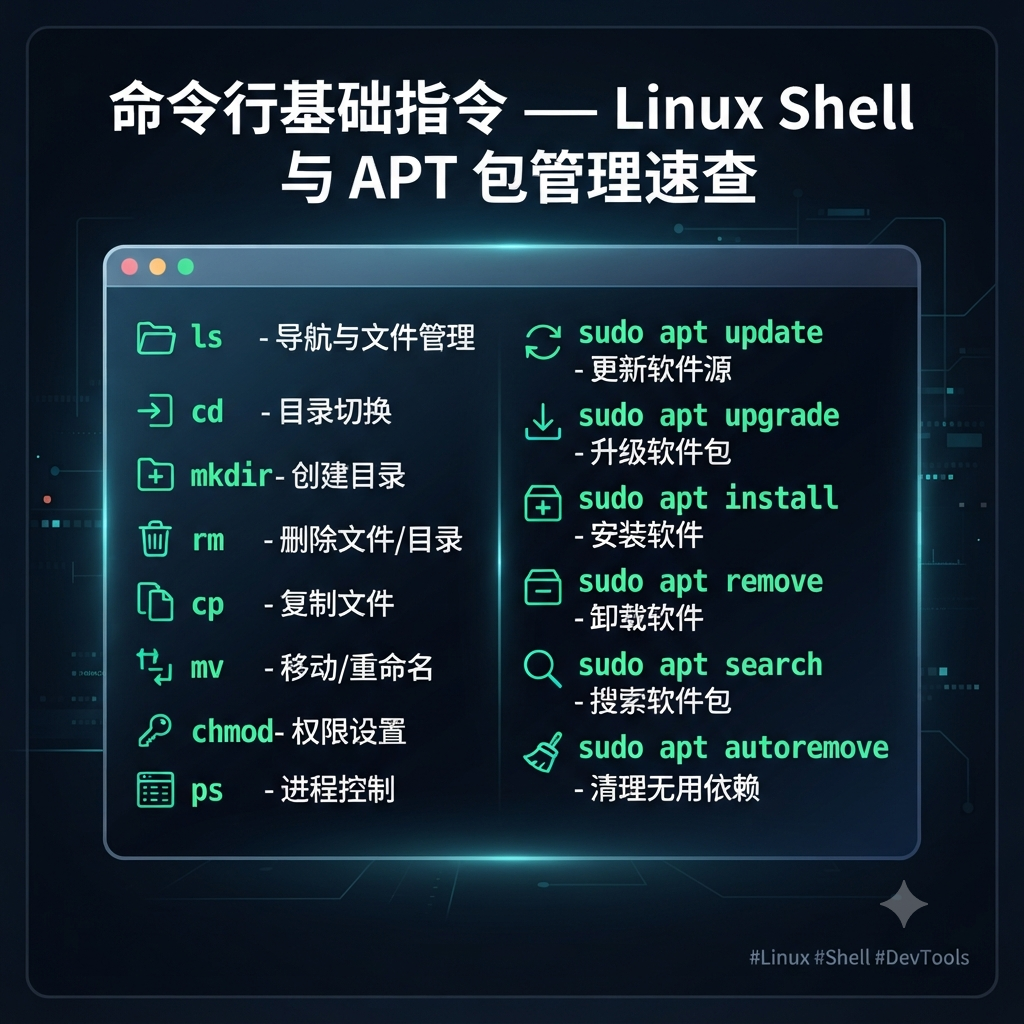
命令行基础指令 —— Linux Shell 与 APT 包管理速查
全面梳理命令行常用操作,涵盖导航、文件管理、权限设置、进程控制、网络工具及 APT 包管理(更新、安装、清理),助你高效驾驭 Linux 终端环境。
—热度
共 74 篇 · 每页 10 篇 · 热度相同时按最新文章优先