Gradient Descent Optimizer —— 梯度下降优化器
2025-08-12
系统梳理梯度下降优化器的完整进化路径:从BGD、SGD到MBGD的效率与稳定性权衡,从动量法与NAG解决峡谷地形震荡,到AdaGrad实现参数级学习率、RMSProp引入指数加权平均解决学习率消亡,最终融合为集大成者Adam,并深入剖析AdamW如何通过解耦权重衰减修复Adam的正则化失效问题。
4127 字
|
21 分钟

MLP & Back Propagation —— 多层感知机与反向传播
2025-08-10
系统讲解多层感知机(MLP)的前向传播矩阵运算与反向传播链式法则,以计算图为工具手动推导3层MLP的误差回传与参数梯度公式,提炼出误差回传、权重梯度、偏置梯度的核心公式。同时讨论通用近似定理(UAT)的砖块构造直觉,以及Batch Normalization训练时mini-batch统计与推理时滑动平均(EMA)机制。
4060 字
|
20 分钟

Autograd & Computational Graph —— 自动微分与计算图
2025-08-08
系统讲解自动微分与计算图的底层原理:从计算图的有向无环图(DAG)结构出发,剖析链式法则是反向传播的“数学引擎”,阐明雅可比矩阵与海森矩阵的几何意义与计算方式,深入解析PyTorch中retain_graph与create_graph的区别与应用场景,对比静态图与动态图的底层哲学差异,并通过手写微型自动微分框架揭示Autograd的本质实现。
5275 字
|
26 分钟

Activation & Initialization —— 激活函数与权重初始化
2025-08-06
系统讲解激活函数与权重初始化的协同演进关系。从Sigmoid/Tanh的梯度饱和问题出发,推导ReLU及其变体(LeakyReLU、PReLU、ELU、GELU、Swish)如何解决梯度消失,并深入推导Xavier初始化(适用于Sigmoid/Tanh)和Kaiming初始化(适用于ReLU)的方差守恒数学原理。
3448 字
|
17 分钟

Probability & Information —— 概率论与信息论基础
2025-08-04
系统讲解深度学习中的概率论与信息论基础:从联合分布、边缘化与贝叶斯定理出发,推导最大似然估计(MLE)的完整四步流程并揭示其与MSE/交叉熵损失的联系,引入最大后验(MAP)估计并阐明L2/L1正则化与高斯/拉普拉斯先验的对应关系,深入剖析KL散度的非对称性及其方向含义,最后证明KL散度、交叉熵与MLE三者的数学等价性。
4721 字
|
24 分钟

Tensor Operations —— 向量、矩阵与张量运算
2025-08-02
系统讲解深度学习中的线性代数基础:从张量的维度与Shape变换出发,深入区分Hadamard积(*)与矩阵乘法(@)的本质差异,解析L1/L2/Frobenius范数的几何意义与机器学习用途,并直观理解特征分解的“换基→缩放→换回”几何解释,以及SVD在降维与数据压缩中的核心价值。
4616 字
|
23 分钟

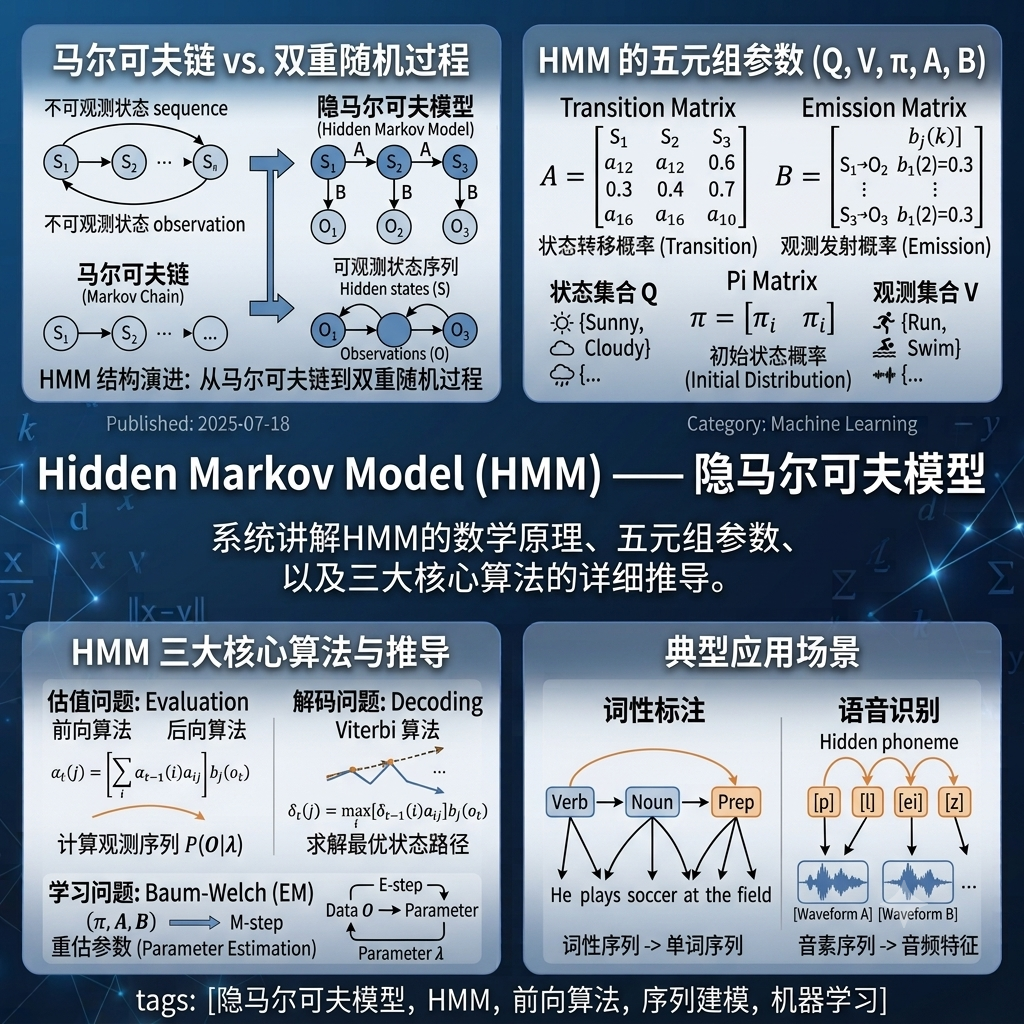
Hidden Markov Model (HMM) —— 隐马尔可夫模型
2025-07-30
系统讲解隐马尔可夫模型(HMM)的完整数学原理与三大核心算法:从马尔可夫链到双重随机过程的演进出发,定义HMM的五元组参数(Q, V, π, A, B);详细推导估值问题、解码问题和学习问题;并通过词性标注、语音识别等经典应用场景展示HMM的实践价值。
5011 字
|
25 分钟
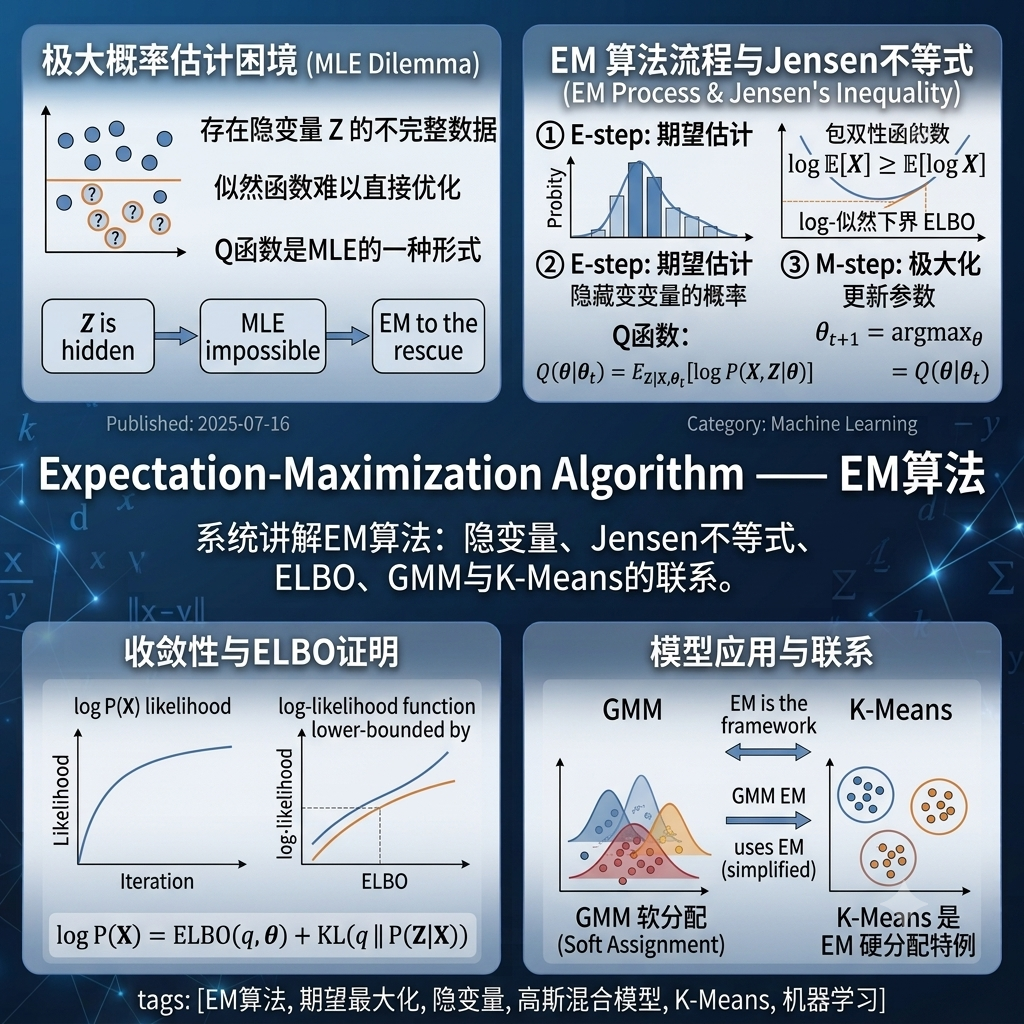
Expectation-Maximization Algorithm —— EM算法
2025-07-28
系统讲解期望最大化(EM)算法的完整数学原理:从极大似然估计在隐变量存在时的困境出发,推导E步与M步的迭代框架;基于Jensen不等式证明ELBO证据下界与收敛性;通过二硬币模型与高斯混合模型(GMM)两个完整实例展示EM的具体计算流程;揭示K-Means是EM在硬分配下的特例这一深层联系。
4993 字
|
25 分钟
K-Means Clustering —— 聚类算法
2025-07-26
系统讲解K-Means聚类的核心原理与算法细节,涵盖Lloyd交替优化算法的收敛性分析、K-Means作为EM算法特例的理论联系(硬分配 vs 软分配)、K-Means++初始化策略的D²采样机制与O(log K)近似保证,以及肘部法则与轮廓系数的选择K值方法及其局限。
5458 字
|
27 分钟

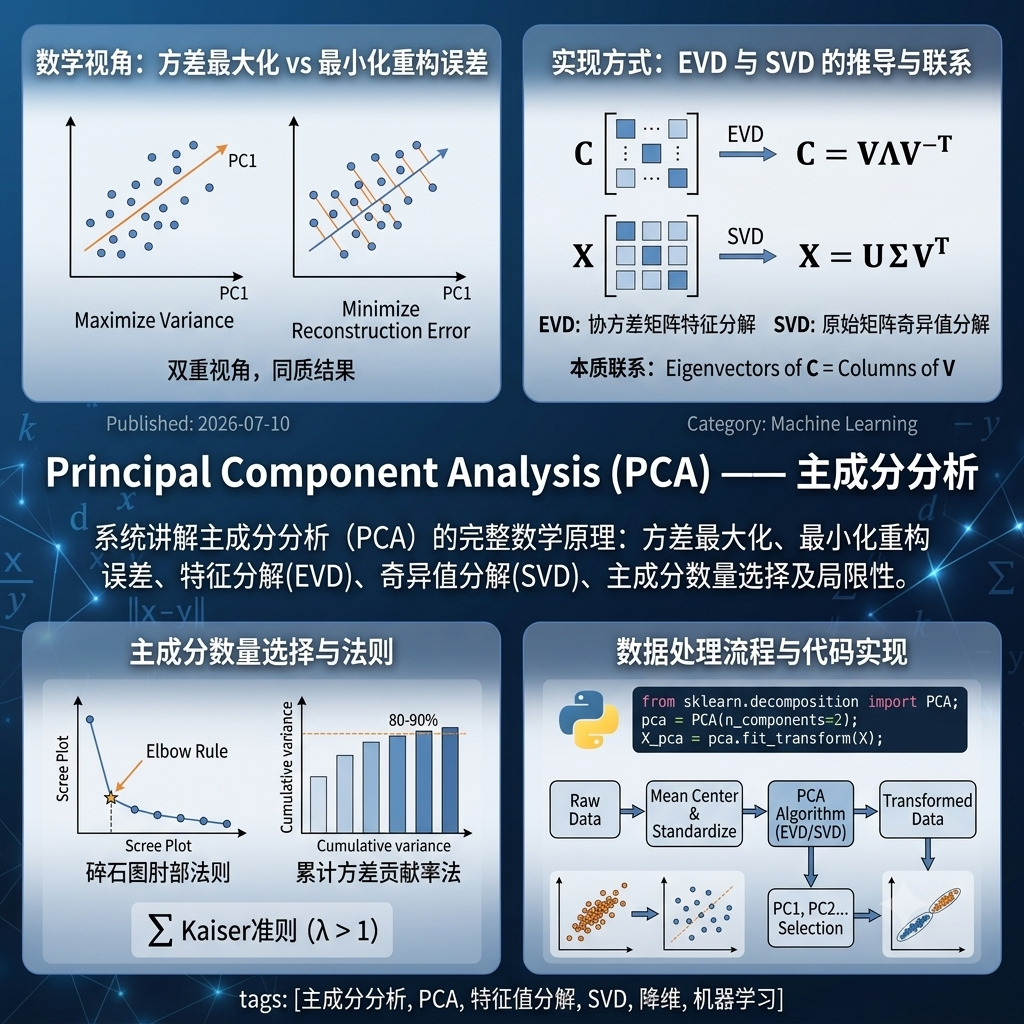
Principal Component Analysis (PCA) —— 主成分分析
2025-07-24
系统讲解主成分分析(PCA)的完整数学原理:从方差最大化与最小化重构误差两个等价视角出发,通过拉格朗日乘子法推导出协方差矩阵的特征方程,揭示特征向量即主成分方向、特征值即主成分方差的本质联系;深入对比EVD与SVD两种实现方式的优劣与适用场景;详细介绍三种主成分数量选择方法;讨论PCA的假设和局限。
5194 字
|
26 分钟